Section
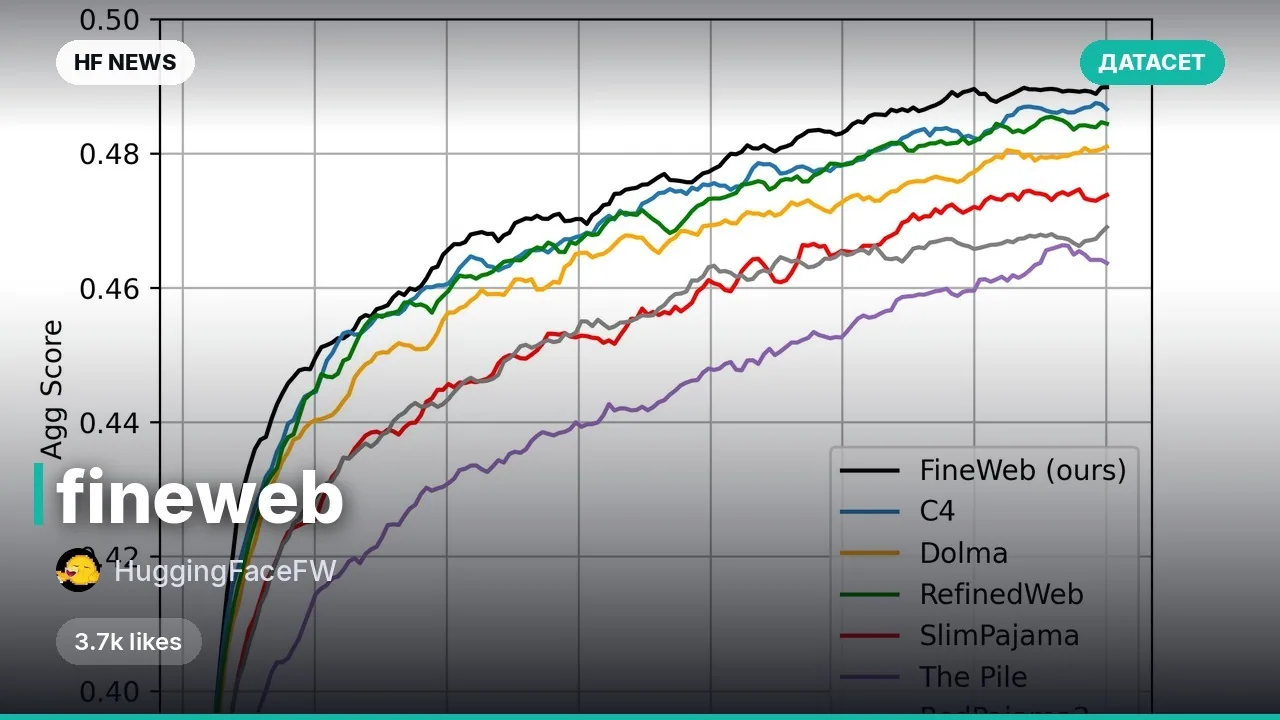
Datasets: notable releases
The most notable new datasets. The full catalog lives in the Datasets tab.
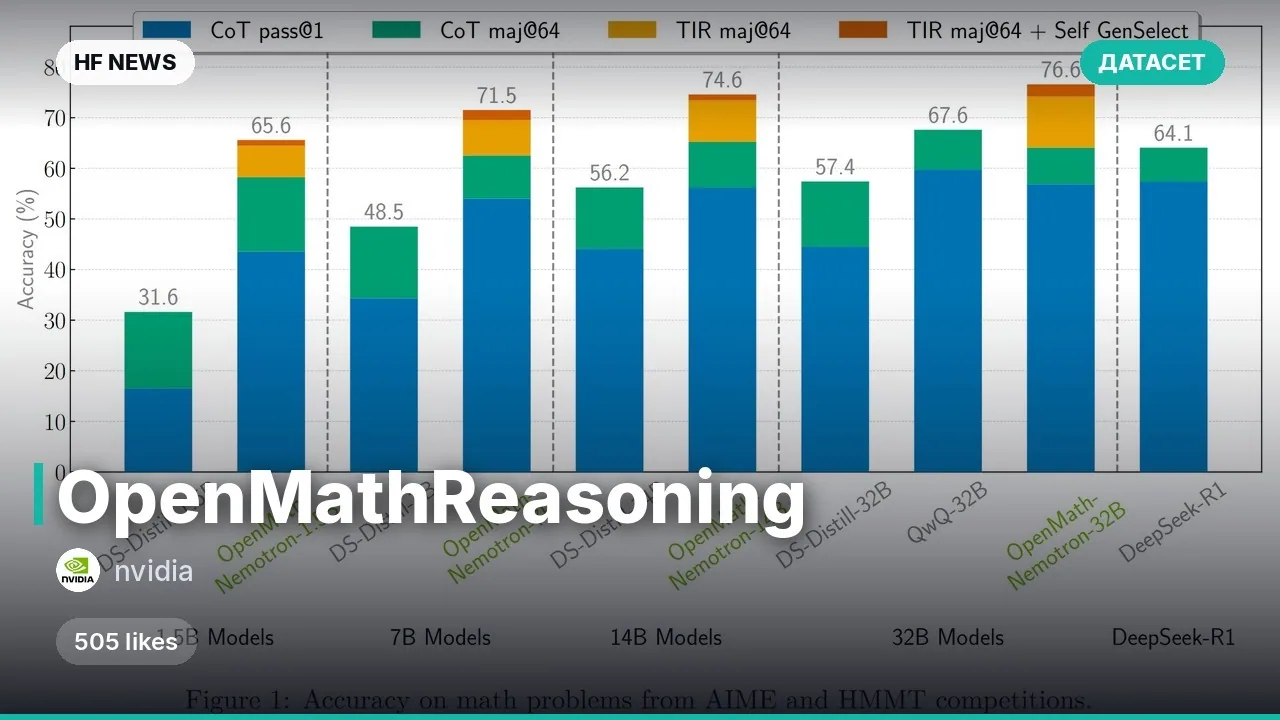
OpenMathReasoning: Large-scale math reasoning dataset from NVIDIA
This dataset contains hundreds of thousands of unique math problems and millions of chain-of-thought solutions generated using cutting-edge models like DeepSeek-R1 and QwQ-32B.
Llama-Nemotron-Post-Training-Dataset
открытый датасет от NVIDIA для обучения LLM рассуждениям
NeyroLearn
@neyrolearn
New models from Hugging Face every morning: video, images, LoRAs and LLMs with examples and links.
- Posts
- 17
- Tags
- 59
Trending
Most liked on Hugging Face this week
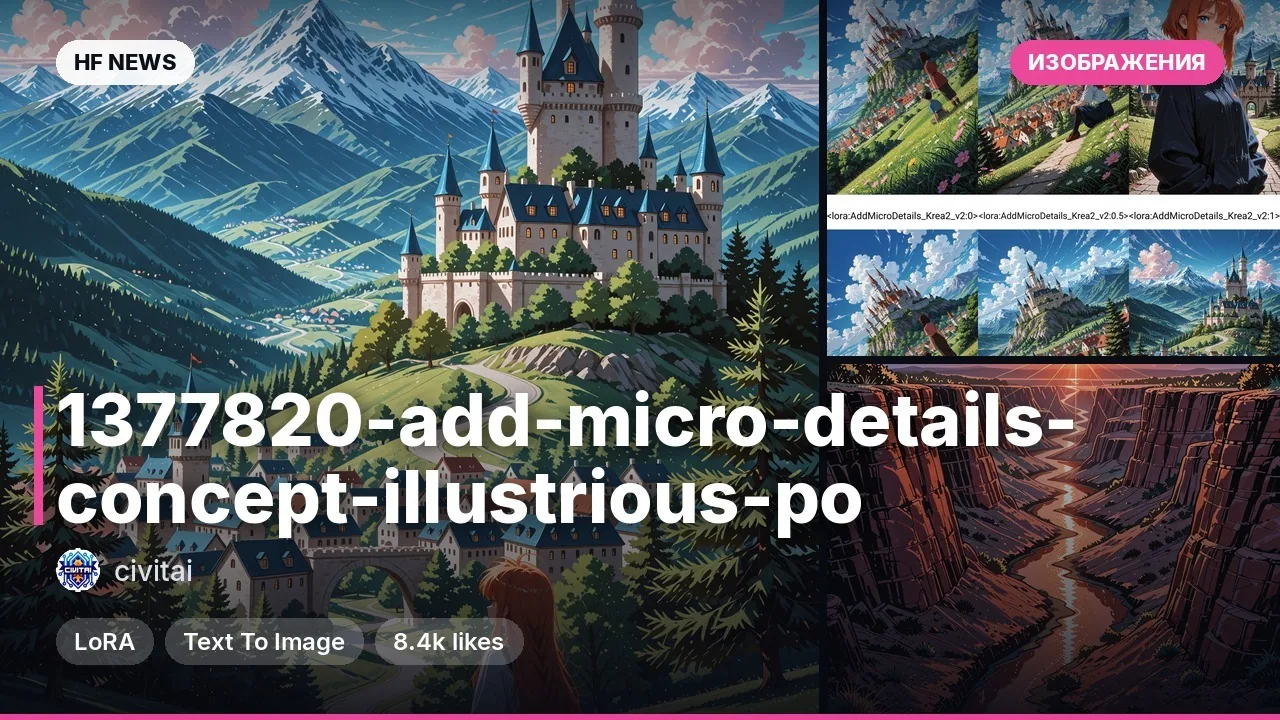
- 1Add Micro Details
Images · 8.4K
 18+
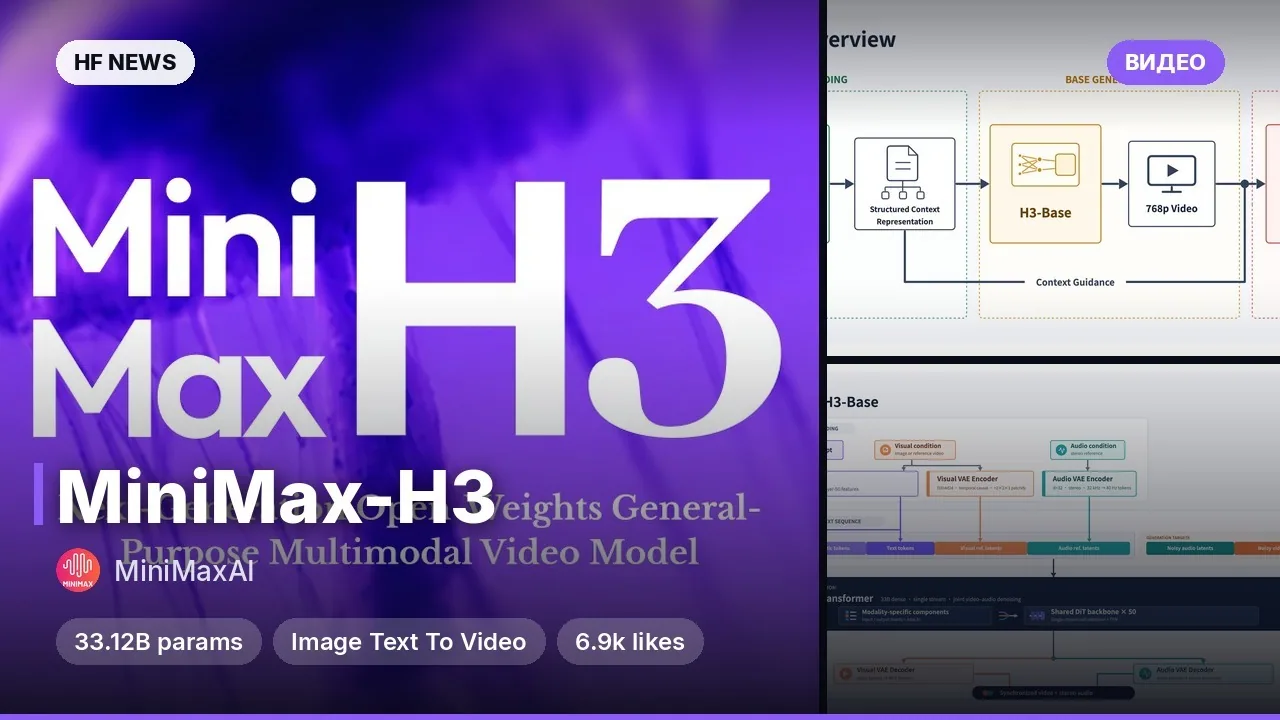
- 2MiniMax-H3
Video · 7.2K
- 3Flat Color - Style
Images · 6.2K
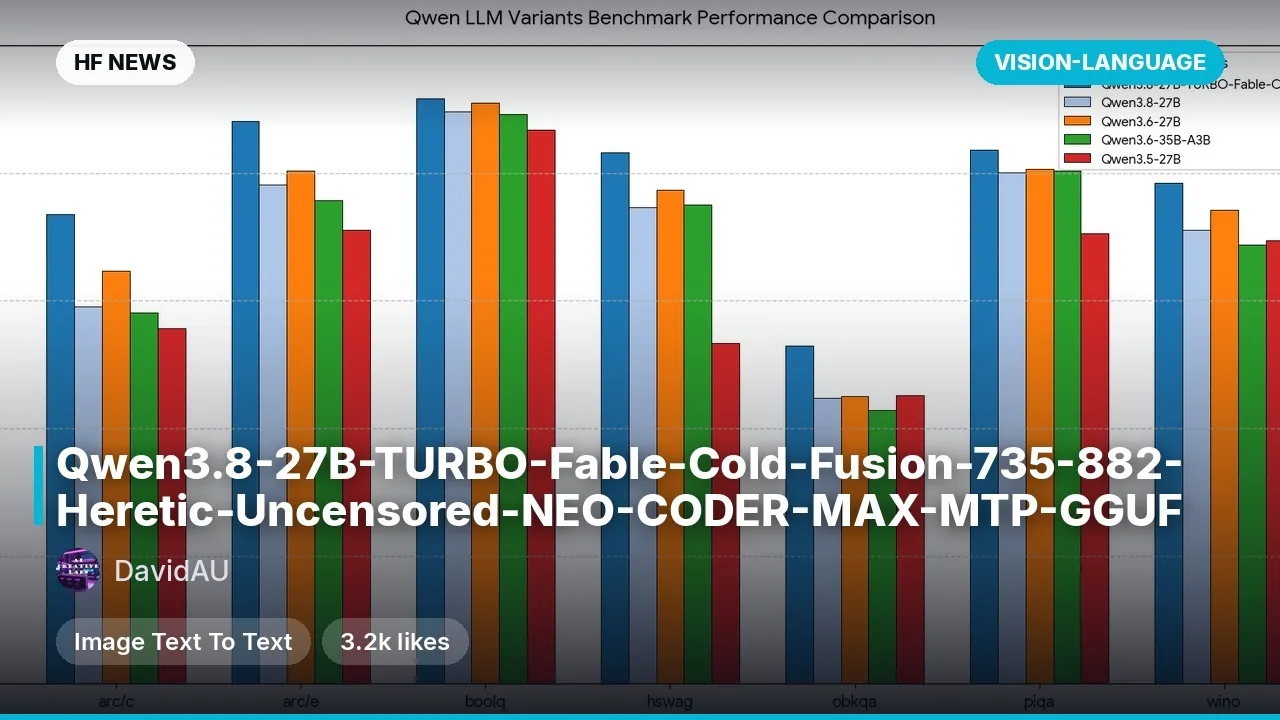
- 4Qwen3.8-27B-TURBO-Fable-Cold-Fusion-735-882-Heretic-Uncensored-NEO-CODER-MAX-MTP-GGUF
Computer vision · 3.5K
- 580s Fantasy Movie
Images · 3.1K
 18+
Popular tags
- #finetune1740
- #LLM1333
- #models1286
- #LoRA1067
- #Qwen923
- #images583
- #txt2img480
- #robotics467
- #VLM346
- #audio269
- #NSFW206
- #Krea192
- #video181
- #MiniMax_H3166
- #ComfyUI155
- #Gemma139
- #turbo127
- #MOSS_Image123
- #ASR107
- #TTS98
About Datasets
These are datasets our AI flagged as especially interesting: large open corpora, rare tasks and languages, new benchmarks.
Thousands of other datasets with descriptions are in the Datasets tab: search by task or language, or describe your goal and the AI will suggest data.