FineWeb2
20 ТБ очищенных текстов на 1000+ языках для обучения LLM
2 min read
Команда Hugging Face выпустила вторую версию знаменитого датасета FineWeb, но теперь не для английского, а для всего остального мира. Внутри около 20 терабайт отфильтрованных и дедуплицированных (очищенных от дублей) текстов: 5 миллиардов документов и более 3 триллионов слов, разбитых на 1868 пар «язык + письменность». Данные собраны из 96 снимков веб-архива CommonCrawl за период с лета 2013 по апрель 2024 года с помощью библиотеки datatrove. По качеству обучения датасет превосходит популярные аналоги вроде mC4, CC-100, CulturaX и HPLT, а русский сегмент здесь вообще самый большой среди всех языков.
Ключевые особенности
- Огромный масштаб и русский язык на первом месте: 1868 языковых поднаборов, а лидер по объёму — русский (
rus_Cyrl): 699 млн документов, 588,5 млрд слов и 1,81 ТБ на диске. - Продуманная очистка и прозрачность: авторы прогнали данные через глобальную дедупликацию, языковые фильтры и анонимизацию персональных данных (PII).
- Доступны даже отсеянные тексты: вместе с чистыми данными выложены сабсеты с суффиксом
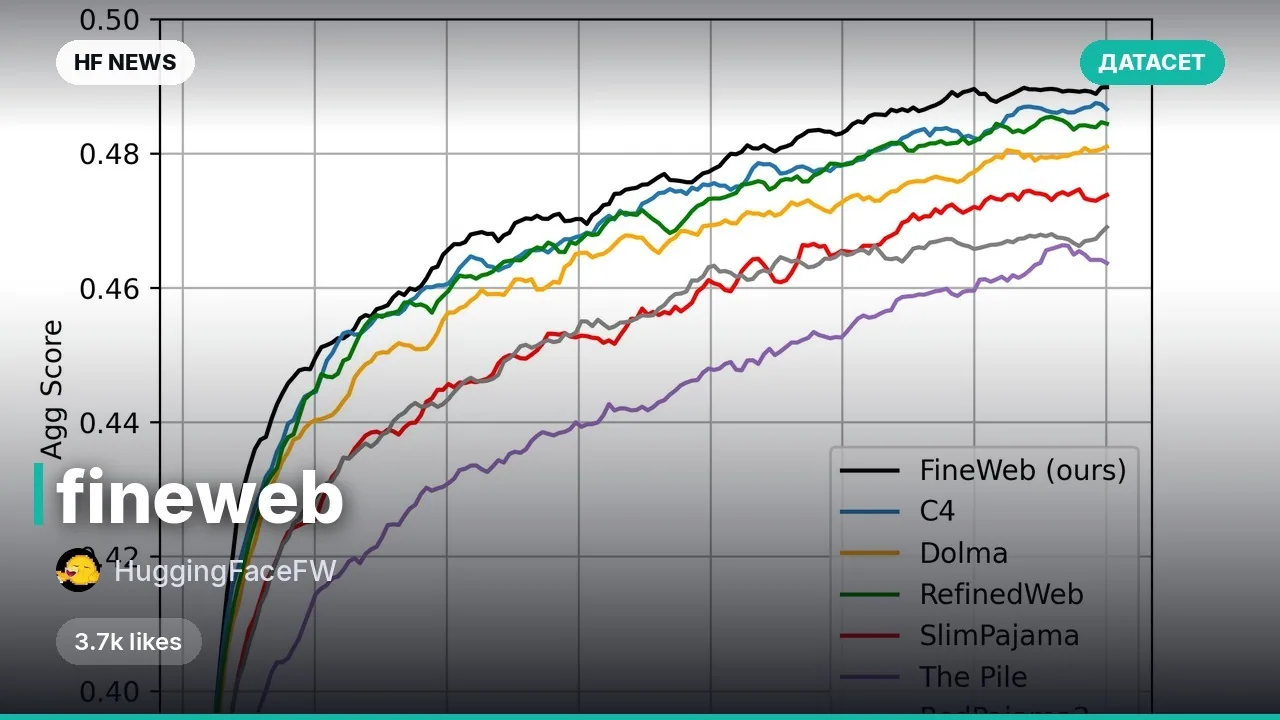
_removed— можно не делать дедупликацию с нуля, а просто применить свои правила фильтрации. - Подтверждённое качество: в серии абляционных экспериментов (проверок влияния каждого этапа очистки) модели на FineWeb2 обошли конкурентов на бенчмарке FineTasks.
Что можно сделать
- Претрейн и дообучение LLM: обучить с нуля или продолжить претрейн мультиязычной или русскоязычной языковой модели на чистом веб-корпусе.
- Кастомная фильтрация данных: скачать связку чистого сабсета и
_removed, чтобы собрать собственную выборку под узкий домен без дорогостоящей повторной дедупликации. - Оценка качества моделей: использовать встроенные сплиты
test(которые присутствуют у большинства языков) для валидации перплексии и генерации.
Пример
from datasets import load_dataset

# Загрузка русского поднабора в потоковом режиме
ds = load_dataset("HuggingFaceFW/fineweb-2", name="rus_Cyrl", split="train", streaming=True)
print(next(iter(ds)))
Подробнее
Объём: ~20 ТБ на диске, 5 млрд документов, >3 трлн слов (английский остался в оригинальном FineWeb).Топ языков: русский (1,81 ТБ), китайский (1,48 ТБ), немецкий (719 ГБ), японский (667 ГБ), испанский (594 ГБ).
Лицензия: открытая ODC-By 1.0, пайплайн обработки полностью воспроизводим на GitHub.
Comments