FineWeb
18,5 трлн токенов чистого английского веба
2 min read
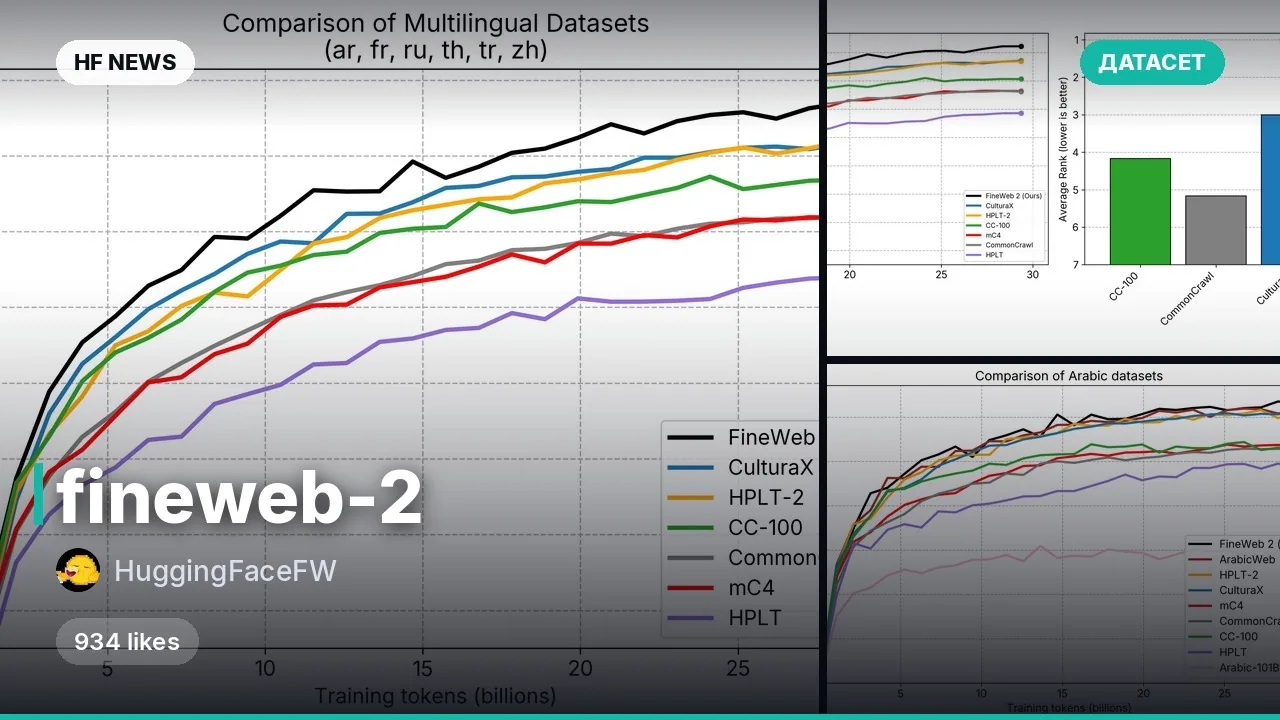
FineWeb — это большой датасет очищенных и дедуплицированных англоязычных веб-страниц из CommonCrawl, собранный HuggingFaceFW для обучения LLM. Внутри более 18,5 трлн токенов, хотя изначально заявлялось 15 трлн. Данные обработаны пайплайном на библиотеке datatrove, оптимизированным под качество обучения языковых моделей. Модели, обученные на FineWeb, по агрегированным бенчмаркам обходят модели на C4, Dolma-v1.6, The Pile, SlimPajama и RedPajama2. Датасет пригодится тем, кто pretrain-ит английские LLM, исследует фильтрацию веб-данных или хочет воспроизвести готовый пайплайн.
Ключевые особенности
- Более 18,5T токенов очищенных и дедуплицированных англоязычных данных CommonCrawl.
- Все дампы CommonCrawl с 2013 года; v1.4.0 добавила шесть снапшотов с января по июнь 2025 года.
- Открытый код обработки на
datatrove— пайплайн можно полностью воспроизвести. - Есть ablation-модели, чекпоинты каждые 1000 шагов и результаты оценки.
- Доступны сэмплы
sample-350BT,sample-100BTиsample-10BT, а также загрузка по отдельным дампам.
Что можно сделать
- Обучить или дообучить англоязычную LLM на полном датасете либо на одном из сэмплов.
- Сравнить стратегии фильтрации и дедупликации на ablation-моделях и готовых бенчмарках.
- Быстро прототипировать на
sample-10BTобъёмом около 10B gpt2-токенов (27,6 ГБ). - Стримить нужный дамп через
datasetsи собрать собственный пайплайн наdatatrove.
Пример
from datasets import load_dataset

fw = load_dataset(
    "HuggingFaceFW/fineweb",
    name="CC-MAIN-2024-10",
    split="train",
    streaming=True,
)
for doc in fw:
    print(doc["text"][:200])
    break
Подробнее
Объём: более 18,5T токенов, все дампы CommonCrawl с 2013 года.Лицензия ODC-By 1.0. Сэмплы: 10BT — 27,6 ГБ, 100BT — 277,4 ГБ, 350BT — 388 ГБ.
v1.4.0 (11.07.2025) добавила CC-MAIN-2025-05…2025-26; в v1.3.0 исправлены неполные дампы и удалены домены по C&D.
Ограничения: только английский язык и веб-данные; возможны смещения и шум.
Comments