FineWeb-Edu
1,3 трлн «учебных» токенов из веба
2 min read
Это не модель, а большой англоязычный датасет из веб-страниц CommonCrawl, отфильтрованных по образовательной ценности. Hugging Face взяли FineWeb и обучили классификатор на оценках Llama3-70B-Instruct: в корпус попали документы с оценкой не ниже 3 по шкале 0–5. На выходе — Parquet-документы, которые можно скачать целиком, по отдельным дампам или в виде сэмплов на 10BT, 100BT и 350BT токенов. Пригодится для предобучения и дообучения LLM, исследований качества данных и обучения собственных фильтров. Отличие от закрытых подборок в том, что здесь открыты и датасет, и классификатор, и код обработки.
Ключевые особенности
- 1,3 трлн токенов образовательных англоязычных страниц; фильтрация убрала 92% исходного FineWeb.
- Классификатор на базе Snowflake-arctic-embed обучен на 500k аннотаций Llama3-70B-Instruct и даёт F1 82% при бинарной классификации.
- Данные в Parquet: все отфильтрованные дампы CommonCrawl с 2013 года, включая обновления до CC-MAIN-2025-26.
- Есть версия FineWeb-Edu-score-2 на 5,4 трлн токенов с менее строгим порогом отбора.
- Дедуплицированная версия доступна в SmolLM-Corpus; по аблациям дедупликация не повлияла на качество модели 1,8B на 350B токенов.
Что можно сделать
- Предобучать или дообучать англоязычные LLM; для проверки подхода есть ablation-модель на 350B токенов.
- Обучать и тестировать классификаторы образовательного качества текста на синтетических аннотациях.
- Исследовать влияние фильтрации веб-данных на бенчмарки и качество обучения.
- Комбинировать корпус с кодом, например The Stack v2, и отдельными курируемыми источниками вроде Википедии.
Пример
from datasets import load_dataset

fw = load_dataset(
    'HuggingFaceFW/fineweb-edu',
    name='sample-10BT',
    split='train',
    streaming=True,
)
print(next(iter(fw)))
Подробнее
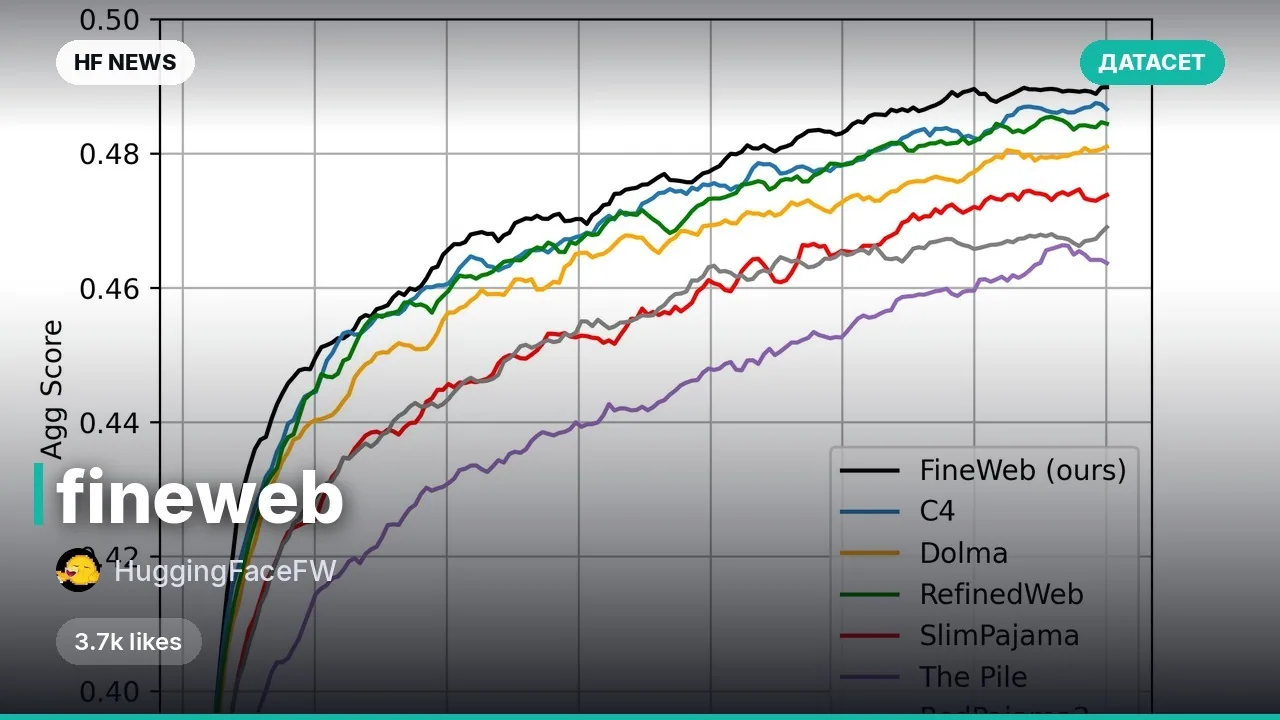
FineWeb-Edu обходит FineWeb и другие открытые веб-датасеты на MMLU, ARC и OpenBookQA; порог 3 дал лучший общий результат.Классификация 15T токенов FineWeb заняла 6k H100 GPU-часов; F1 классификатора — 82%.
Ограничения: только английский, мало кода, возможны токсичные и предвзятые фрагменты. Лицензия — ODC-By v1.0 и условия CommonCrawl.
Comments