New VLMs · page 15
Multimodal models that understand text and images.
gemma-3-4b-it-DUET-film-ft
full-parameter файнтюн Gemma 3 для исследования unlearning фильмов
Mage Hand
Mage-VL-Cowork-hands-v2 — GUI-grounding с акцентом на точность клика
K-Oss 8 Mini Instruct
8B мультимодальная модель с фокусом на индонезийский и японский
PANORAMA-2B
паноптический grounded captioning с маской для каждой фразы
NeyroLearn
@neyrolearn
New models from Hugging Face every morning: video, images, LoRAs and LLMs with examples and links.
- Posts
- 348
- Tags
- 59
Trending
Most liked on Hugging Face this week
- 1Add Micro Details
Images · 8.4K
 18+
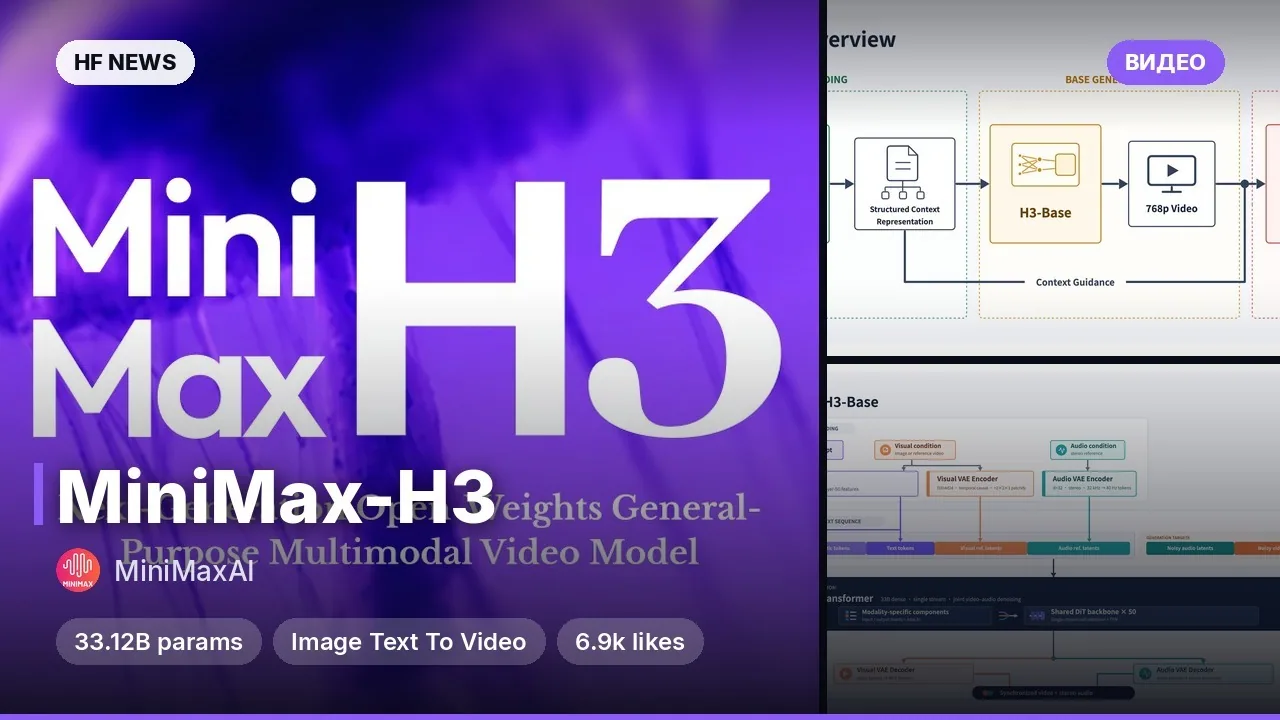
- 2MiniMax-H3
Video · 7.2K
- 3Flat Color - Style
Images · 6.2K
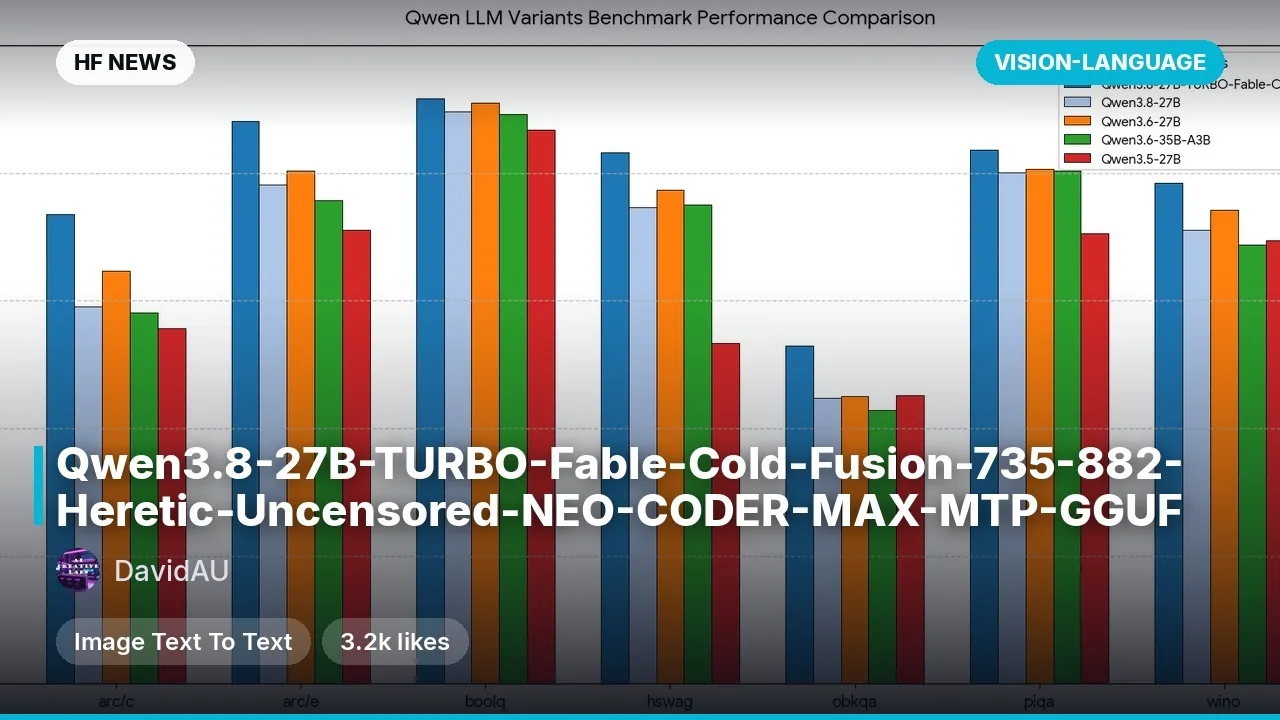
- 4Qwen3.8-27B-TURBO-Fable-Cold-Fusion-735-882-Heretic-Uncensored-NEO-CODER-MAX-MTP-GGUF
Computer vision · 3.5K
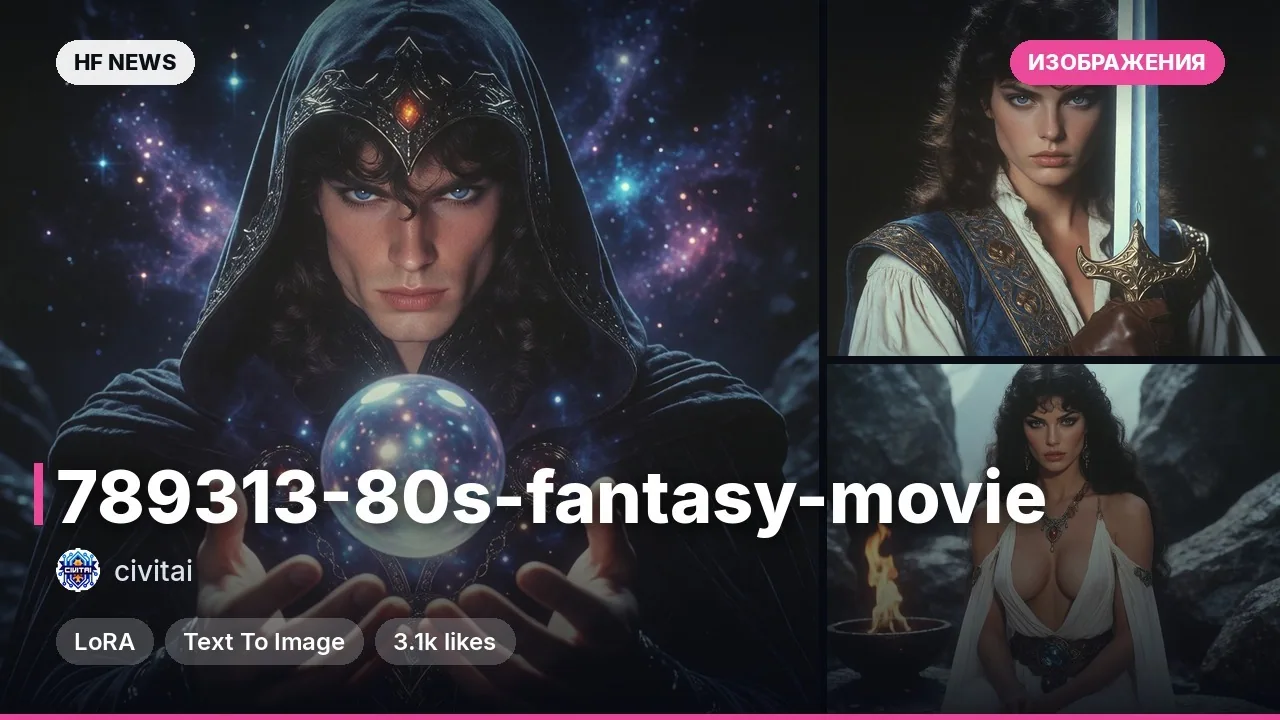
- 580s Fantasy Movie
Images · 3.1K
 18+
Popular tags
- #finetune1750
- #LLM1342
- #models1293
- #LoRA1071
- #Qwen930
- #images585
- #txt2img482
- #robotics467
- #VLM348
- #audio270
- #NSFW207
- #Krea193
- #video185
- #MiniMax_H3170
- #ComfyUI159
- #Gemma139
- #turbo128
- #MOSS_Image123
- #ASR107
- #TTS99