MiniMax-H3-Image-pDMD-2steps
генерация и редактирование фото за 2 шага
2 min readupdated
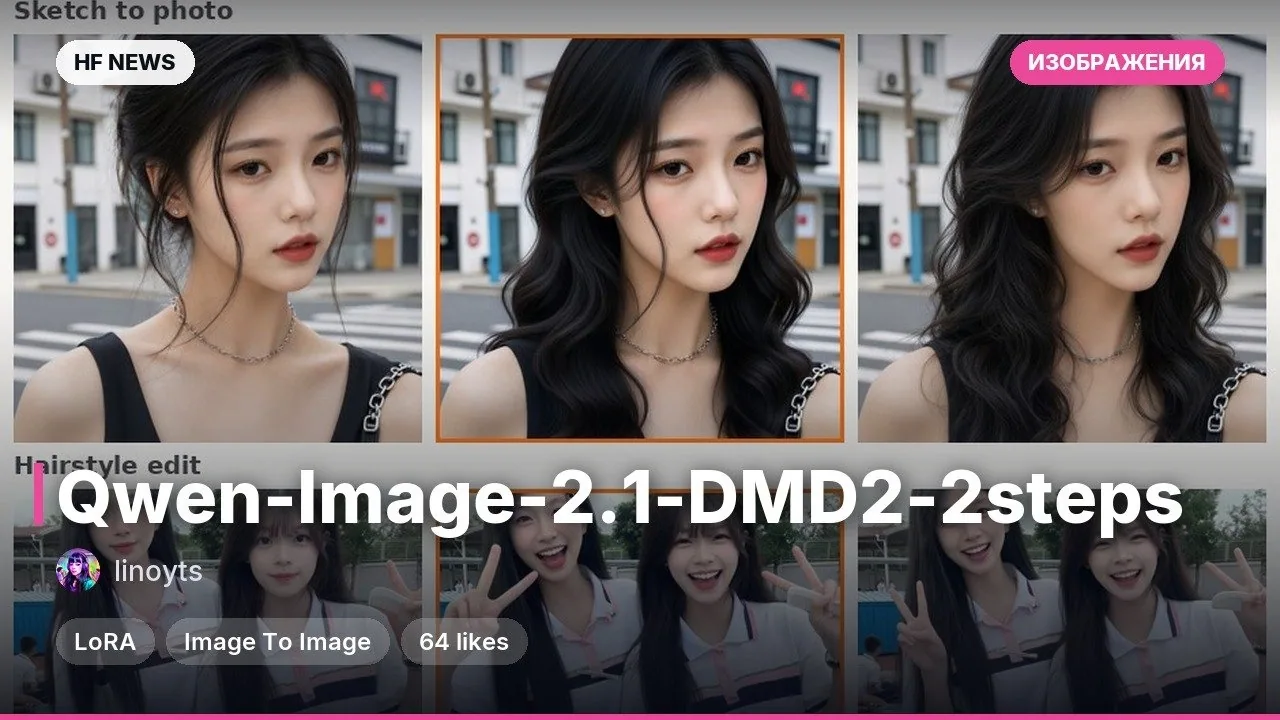
Это дистилляционная LoRA (небольшая надстройка над базовой моделью) от разработчицы linoyts для модели MiniMax-H3-Image. Она сжимает стандартную генерацию с 6 шагов до 2 проходов, при этом качество создания картинок по тексту и редактирования по референсам остаётся близким к оригиналу. Адаптер обучен методом pDMD (Distribution Matching Distillation — перенос знаний от 6-шаговой модели-учителя к быстрой версии) в разрешении около 1 мегапикселя. Благодаря трёхкратному ускорению модель подходит для интерактивных и близких к реальному времени пайплайнов.
Ключевые особенности
- 2 шага вместо 6: используется расписание
sample_sigmas=[1.0, 12/13, 0.0], при котором задействуются первые две выходные головы трансформера. - Поддержка редактирования: помимо генерации с нуля (text-to-image), сохраняет способность править референсные изображения по тегам
,в промпте. - Работа без CFG: как и базовая модель с дистилляцией гайданса, работает без параметров
guidance_scaleиnegative_prompt. - Несколько соотношений сторон: обучена на форматах 1024×1024, 768×1344 и 1344×768 на расширенных промптах от
MiniMax-H3-Image-PE.
Что можно сделать
- Ускорить генерацию в 1 Мп: встраивать LoRA в веса базового
MiniMax-H3-Imageв библиотекеdiffusersдля быстрой генерации иллюстраций с подробными описаниями. - Редактировать фото по референсам: менять детали на загруженных снимках (например, убирать лишние предметы или менять позы персонажей) всего за два прохода нейросет.
- Связать с расширителем промптов: объединить в одном пайплайне с
MiniMax-H3-Image-PE, чтобы короткие запросы автоматически превращались в детальные описания перед быстрой генерацией.
Пример
lora_path = hf_hub_download("linoyts/MiniMax-H3-Image-pDMD-2steps", "pytorch_lora_weights.safetensors")
fuse_lora(pipe.transformer, lora_path)
pipe.register_to_config(sample_sigmas=[1.0, 12 / 13, 0.0])

image = pipe(
    prompt="Keep everything in  as it is, but remove the headphones and have the two hosts fist bump.",
    image=reference, height=1024, width=1024, min_generation_area=1024, output="images"
)[0]
Подробнее
Обучение: 1000 шагов на одной видеокарте H100 (rank 128, alpha 128 для слоёв attention и feed-forward).Железо: трансформер и текстовый энкодер весят около 62 ГБ каждый в
bfloat16, требуется ~140 ГБ CPU RAM при включённом авто-оффлоадинге.Ограничения: при запуске обязательно передавать
min_generation_area=1024, иначе пайплайн по умолчанию генерирует холст от 4 Мп, на который LoRA не рассчитана; требует diffusers>=0.43.0 и Python 3.11+.





Comments