Skip to content
Robotics

urdf2vla-crx3ia-gr00t-n1.7

управление роборукой FANUC в симуляторе

2 min readupdated

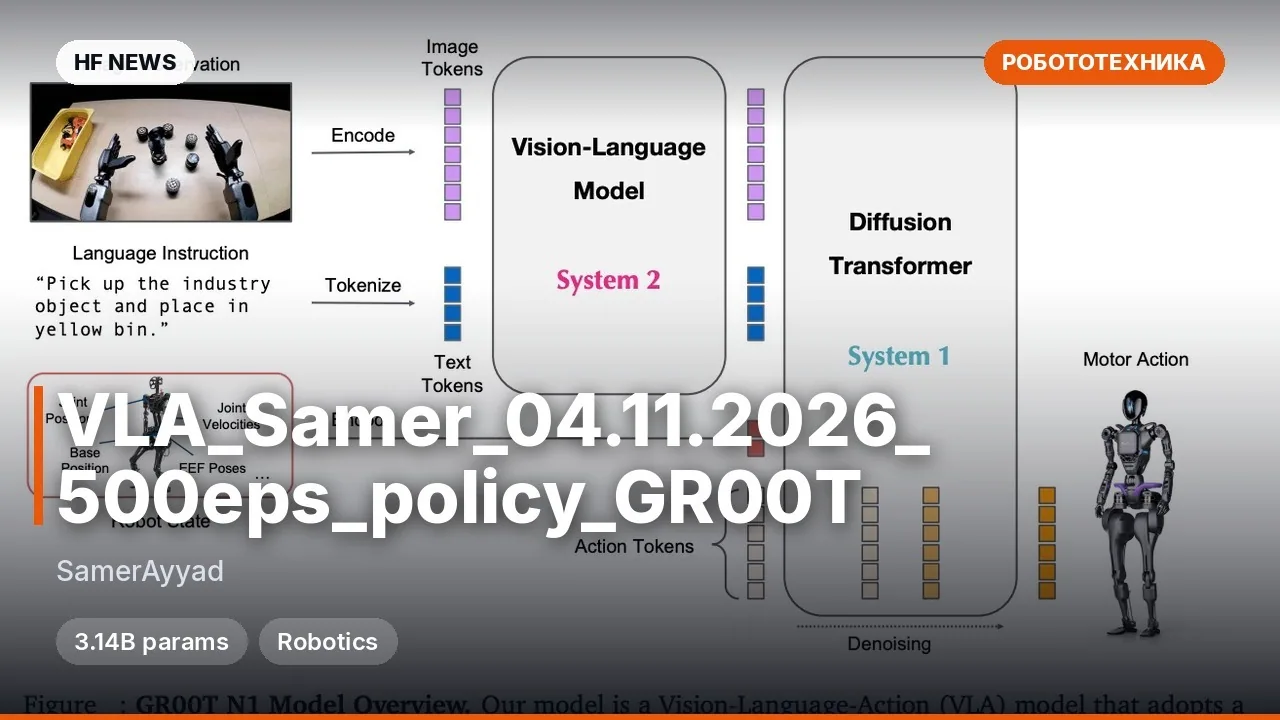
Это VLA-модель (Vision-Language-Action — нейросеть, которая связывает картинку, текстовую команду и физические действия) для робоманипулятора FANUC CRX-3iA с захватом Robotiq 2F-85 в симуляторе NVIDIA Isaac Sim. Модель получает команду на английском языке, например «put the apple in the bin», анализирует поток с трёх камер и текущее положение суставов, а на выходе выдаёт последовательность из 16 шагов управления рукой и захватом. Она основана на nvidia/GR00T-N1.7-DROID (3.14 млрд параметров) и обучена автором umegan сквозным пайплайном urdf2vla напрямую из URDF-описания робота. От базовой версии чекпоинт отличается адаптацией под конкретную кинематику FANUC и конфигурацию из трёх камер (на запястье, слева и справа). Пригодится разработчикам робототехники и исследователям для тестов и экспериментов с VLA в симуляции.

Ключевые особенности

  • Трёхкамерное зрение: принимает текущие RGB-кадры 256×256 сразу с трёх точек — wrist_cam, left_cam и right_cam.
  • Точное управление суставами: на частоте 20 Hz предсказывает 16 шагов целевых углов для 6 осей манипулятора (J1–J6) и состояние захвата.
  • Лёгкое дообучение: при файнтюнинге замораживались языковая модель и визуальный энкодер, обучались только проектор и диффузионная голова действий.
  • Стопроцентный результат в тесте: в симуляции успешно выполнила 20 из 20 эпизодов перекладывания яблока, кубика, лайма и груши.

Что можно сделать

  • Оценить работу в Isaac Sim: запустить готовую валидацию на 20 эпизодах с записью видео, чтобы посмотреть, как модель захватывает и переносит объекты в корзину.
  • Использовать как шаблон для своего робота: взять конфигурацию urdf2vla_modality_crx3ia.py и пример из репозитория urdf2vla для переноса пайплайна на другие URDF-модели манипуляторов.
  • Дообучить на новые сценарии: расширить датасет демонстраций за пределы четырёх стандартных объектов и одного стола.

Пример

hf download umegan/urdf2vla-crx3ia-gr00t-n1.7 --local-dir projects/crx3ia/training/hf_crx3ia
mkdir -p projects/crx3ia/datasets/demos_gr00t
cp projects/crx3ia/training/hf_crx3ia/urdf2vla_modality_crx3ia.py projects/crx3ia/datasets/demos_gr00t/
urdf2vla evaluate_vla --project projects/crx3ia --model training/hf_crx3ia --episodes 20 --video
ПодробнееМетрики: 20/20 успешных эпизодов, медианное отклонение от цели — 15 мм, средняя длина эпизода — 174 шага (8.7 с).
Обучение: 50 скриптовых демонстраций, 10 000 шагов с batch size 32 на одной NVIDIA L40S (пик 41.9 GB VRAM, 2 ч 40 мин).
Ограничения: работает только в симуляции (на реальном роботе не проверялась), обучена на одной сцене с фиксированным освещением и 4 типами объектов.
Лицензия: NVIDIA Open Model License (содержит замороженные веса nvidia/Cosmos-Reason2-2B).


Видео-примеры
Discuss Telegram 0 30

Will it run?

Runs in F32

Fits without quantisation.

  • F32weights 12 GB · ready files13 GB
  • BF16weights 5.9 GB6.9 GB
  • FP8 / INT8recommendedweights 2.9 GB3.7 GB
  • 4-bitweights 1.6 GB2.3 GB

Tip: go 8-bit.FP8 / INT8 is within about a percent of full precision in quality, takes half the memory and runs faster on RTX 40/50 and H100. Full precision only pays off for fine-tuning.

What to get for this model

Massed ComputeOpen Massed Compute

Your own GPU: FP8 / INT8 — from RTX 2060 · F32 — from RTX 5080

Massed Compute hourly prices, November 2026. The discounted price applies with the coupon at checkout.

Estimate: weights plus working memory. Long videos, high resolutions and long contexts need more.

Run it on Massed Compute

The script downloads the model to the rented machine. How to run it is in the model card.

  1. 1. Rent a machine with a fitting GPU

    Open Massed Compute
  2. 2. Paste the script into the machine's terminal

    Connect over SSH (the Massed Compute panel shows the command) or open a terminal on the machine's desktop.

    HF_TOKEN / CIVITAI_TOKENThe script starts with token lines: paste yours between the quotes. The Hugging Face token is for gated models, the Civitai one for Civitai models.

    # umegan/urdf2vla-crx3ia-gr00t-n1.7
    mkdir -p ~/models
    curl -LsSf https://astral.sh/uv/install.sh | sh
    source "$HOME/.local/bin/env"
    uv tool install "huggingface_hub[cli]"
    hf download umegan/urdf2vla-crx3ia-gr00t-n1.7 --local-dir ~/models/urdf2vla-crx3ia-gr00t-n1.7
    # The model is in ~/models. How to run it is in the model card (link above).
  3. 3. Use it

    The model is in ~/models. How to run it is in the model card (link above).

Stop the machine in the panel when you are done: it bills by the minute while it runs.

How to speed it up

Picked for this model type. Choose your hardware above to see what fits you exactly.

  • FlashAttention 44.0.0b40from November 18, 2026new release

    fastest exact attention on B200

    Kernels for Blackwell (beta). Exact attention without quantisation — fine for everything, LLMs included.

    How to enable: pip install flash-attn-4; vLLM and SGLang pick it up themselves.

    Earlier generations (2)
    • FlashAttention 3 — The Hopper (H100/H200) version with FP8.
    • FlashAttention 2 — The standard for RTX 30/40/50 and A100: exact attention without the memory cost of long contexts.
  • torch.compile2.15.0from October 28, 2026new release

    10–30% for free

    Compiles the model for your GPU. Slower first run, faster afterwards.

    How to enable: model = torch.compile(model); in ComfyUI the TorchCompileModel node.

Model family

New posts about versions of GR00T-N1.7-DROID (quants, finetunes, LoRAs) will show up under the bell.

Fine-tunes 4All on Hugging Face

About the model

umegan/urdf2vla-crx3ia-gr00t-n1.7
Author
umegan
Category
Robotics
Released
Posted

On NeyroLearn

Hugging Face

300

Ask AI about this model

Answered by Gemini 4 · the chat is kept only in this tab

Comments