Skip to content
Robotics

RobotisSW/Task905-943-GR00T-VisionKL-Tactile

двухэтапное дообучение GR00T-N1.7-3B с тактильным энкодером

2 min readupdated

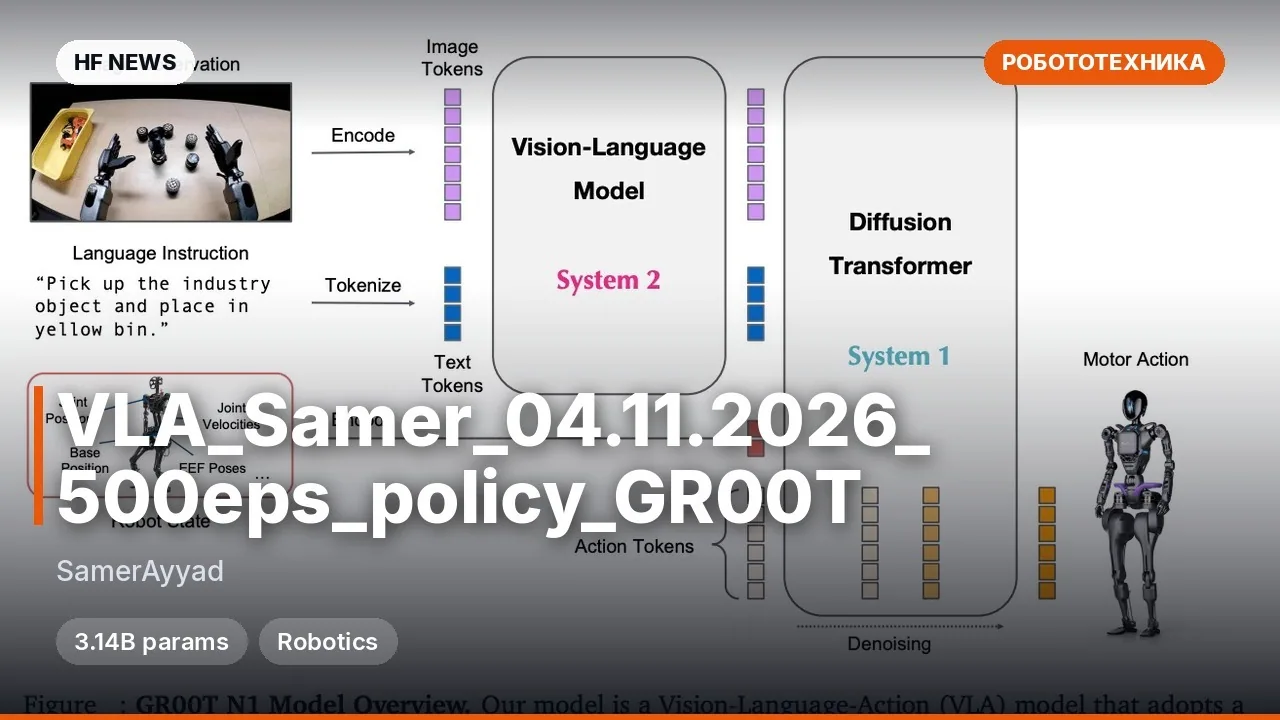
Публичный архив с чекпоинтами двухэтапного обучения робототехнической модели nvidia/GR00T-N1.7-3B от пользователя RobotisSW для выполнения задач манипуляции (Task 905 и 943). На первом этапе выполняется KL-тюнинг (настройка по дивергенции Кульбака — Лейблера) всей визуальной башни модели при замороженных языковом модуле (LLM) и модуле действий. На втором этапе замораживается уже вся визуально-языковая часть (VLM), а дообучаются модуль действий и существующий тактильный энкодер finger_mlp. Модель ориентирована на исследователей в области робототехники и мультимодальных систем управления манипуляторами (VLA).

Ключевые особенности

  • Построена на базе робототехнической модели nvidia/GR00T-N1.7-3B с использованием библиотеки transformers.
  • Двухэтапный пайплайн (эксперимент SH5): сначала настройка визуального энкодера (шаги 500 и 1000), затем обучение тактильного энкодера finger_mlp и головы действий (шаги 20000–100000).
  • Обучение проводилось совместно на задачах 905 и 943 (174 эпизода, 77 860 кадров) с использованием масок SAM для рабочей руки и сенсорной площадки без letterbox-паддинга.
  • Каждый чекпоинт содержит веса, процессоры, статистику, конфигурацию, состояния оптимизатора/планировщика и манифест контрольных сумм для возобновления обучения.

Что можно сделать

  • Продолжить дообучение робототехнического агента на собственных задачах манипуляции с сохраненного состояния оптимизатора и планировщика.
  • Использовать сохраненные веса визуально-языковой части (VLM) и тактильного модуля finger_mlp для исследований мультимодального управления роботами на базе GR00T-N1.7.

Пример

В карточке репозитория указано, что чекпоинты сохраняются по мере прохождения шагов обучения (500 и 1000 для стадии Vision; 20000, 40000, 60000, 80000 и 100000 для стадии Action) и включают полные состояния Trainer, веса модели и конфигурацию из setup/archive_policy.json для возобновления пайплайна. Исходные видео демонстраций в репозиторий не загружены.

ПодробнееОбучение запущено 15 ноября 2026 года; чекпоинты публикуются по мере достижения контрольных шагов.
Отбор лучшего чекпоинта на отложенной выборке и проверка развертывания на реальном роботе не проводились (шаг 1000 — плановая точка завершения стадии Vision, а не лучший результат по метрикам).
Метрики процесса обучения отслеживаются в Weights & Biases (проекты sw-tuning-sh5-905-943).

Discuss Telegram 0

Will it run?

Runs in BF16

Fits without quantisation.

  • BF16weights 12 GB · ready files13 GB
  • FP8 / INT8recommendedweights 5.9 GB6.9 GB
  • 4-bitweights 3.3 GB4.1 GB

Tip: go 8-bit.FP8 / INT8 is within about a percent of full precision in quality, takes half the memory and runs faster on RTX 40/50 and H100. Full precision only pays off for fine-tuning.

What to get for this model

Massed ComputeOpen Massed Compute

Your own GPU: FP8 / INT8 — from RTX 5060 Ti 8GB · BF16 — from RTX 5080

Massed Compute hourly prices, November 2026. The discounted price applies with the coupon at checkout.

Estimate: weights plus working memory. Long videos, high resolutions and long contexts need more.

Run it on Massed Compute

The script downloads the model to the rented machine. How to run it is in the model card.

  1. 1. Rent a machine with a fitting GPU

    Open Massed Compute
  2. 2. Paste the script into the machine's terminal

    Connect over SSH (the Massed Compute panel shows the command) or open a terminal on the machine's desktop.

    HF_TOKEN / CIVITAI_TOKENThe script starts with token lines: paste yours between the quotes. The Hugging Face token is for gated models, the Civitai one for Civitai models.

    # RobotisSW/Task905-943-GR00T-VisionKL-Tactile
    mkdir -p ~/models
    curl -LsSf https://astral.sh/uv/install.sh | sh
    source "$HOME/.local/bin/env"
    uv tool install "huggingface_hub[cli]"
    hf download RobotisSW/Task905-943-GR00T-VisionKL-Tactile --local-dir ~/models/Task905-943-GR00T-VisionKL-Tactile
    # The model is in ~/models. How to run it is in the model card (link above).
  3. 3. Use it

    The model is in ~/models. How to run it is in the model card (link above).

Stop the machine in the panel when you are done: it bills by the minute while it runs.

How to speed it up

Picked for this model type. Choose your hardware above to see what fits you exactly.

  • FlashAttention 44.0.0b40from November 18, 2026new release

    fastest exact attention on B200

    Kernels for Blackwell (beta). Exact attention without quantisation — fine for everything, LLMs included.

    How to enable: pip install flash-attn-4; vLLM and SGLang pick it up themselves.

    Earlier generations (2)
    • FlashAttention 3 — The Hopper (H100/H200) version with FP8.
    • FlashAttention 2 — The standard for RTX 30/40/50 and A100: exact attention without the memory cost of long contexts.
  • torch.compile2.15.0from October 28, 2026new release

    10–30% for free

    Compiles the model for your GPU. Slower first run, faster afterwards.

    How to enable: model = torch.compile(model); in ComfyUI the TorchCompileModel node.

Model family

New posts about versions of GR00T-N1.7-3B (quants, finetunes, LoRAs) will show up under the bell.

Quantised versions 3All on Hugging Face
Fine-tunes 12All on Hugging Face
LoRAs and adapters 1All on Hugging Face

About the model

RobotisSW/Task905-943-GR00T-VisionKL-Tactile
Author
RobotisSW
Category
Robotics
Released
Posted

On NeyroLearn

Hugging Face

00

Ask AI about this model

Answered by Gemini 4 · the chat is kept only in this tab

Comments