ViFastTts N0 — Ngọc Huyền — исследовательская TTS-модель для вьетнамского языка от dvchd. Это один женский голос, acoustic-модель small на 6,1 млн параметров и 24 kHz; в репозитории есть checkpoint, config, ONNX FP32 и б
compctx-0.8b от aksern — текстовый файнтюн Qwen/Qwen3.5-0.8B (752M параметров, Qwen3_5ForCausalLM). Он не для диалогов, а для сжатия execution trace агента в краткую память: цель, ограничения, сделанное, ошибки, решения
Vemana-Base от Udgam Labs — базовая языковая модель для телугу на 278M параметров. Обучена с нуля на 5,1 млрд уникальных токенов публичного веб-текста на телугу (12 млрд токен-позиций), использует собственный токенизатор
DSpark — это draft-модель для speculative decoding от OpenBMB, предназначенная для MiniCPM-OCR 1.0. Она не работает как самостоятельная OCR-модель: её нужно использовать в паре с основной 1.3B-моделью из того же релиза.
корейский файнтюн Qwen MoE с честными компромиссами
Keural Nova 1.1 — instruction-tuned модель от MKD на базе Qwen/Qwen3.6-35B-A3B (Apache 2.0): 35B параметров MoE и ~3B активных на токен. Это SFT через LoRA, слитую в веса, на 253 528 примерах (~85% корейский, 15% английс
студийные портреты вымышленных персонажей с абсурдной геометрией лиц
Это LoRA-адаптер для text-to-image от akatz-ai (Akatz Labs), сделанный для OpenCast Studio. Добавляет к Krea 2 узнаваемый стиль: фотоматериалы и студийный свет, намеренно необычные пропорции, скульптурные причёски, правд
vela3-turbo — референсная модель семейства Vela 3.0 от vLLM Semantic Router × KR Labs. Построена на d3-turbo v1.0: 26,09B параметров плюс 5044 MB адаптеров и голов, лицензия Apache-2.0. За один вызов system_one отвечает
Orbit-4-Gemma-E4B-it — LLM от OpenPathAI, дообученная с google/gemma-3n-E4B-it для лучшего понимания индонезийского языка. Размер — 7,82 млрд параметров; архитектура Gemma 3n сохраняет мультимодальные возможности, но тюн
Это Qwen2.5-0.5B-Instruct, дообученная через LoRA и слитая в полные веса. Академическая работа Universidad Adolfo Ibáñez: модель должна объяснять понятия генеративного ИИ чилийским руководителям. Размер — 0,49 млрд парам
Это LoRA-адаптер для LiquidAI/LFM2.5-24B-A2B от harness-hub. Обучен с подкреплением через AsyncGRPO в TRL как модель для кодинг-агента pi на задачах анализа данных: каждый rollout — полная сессия pi в удалённом sandbox с
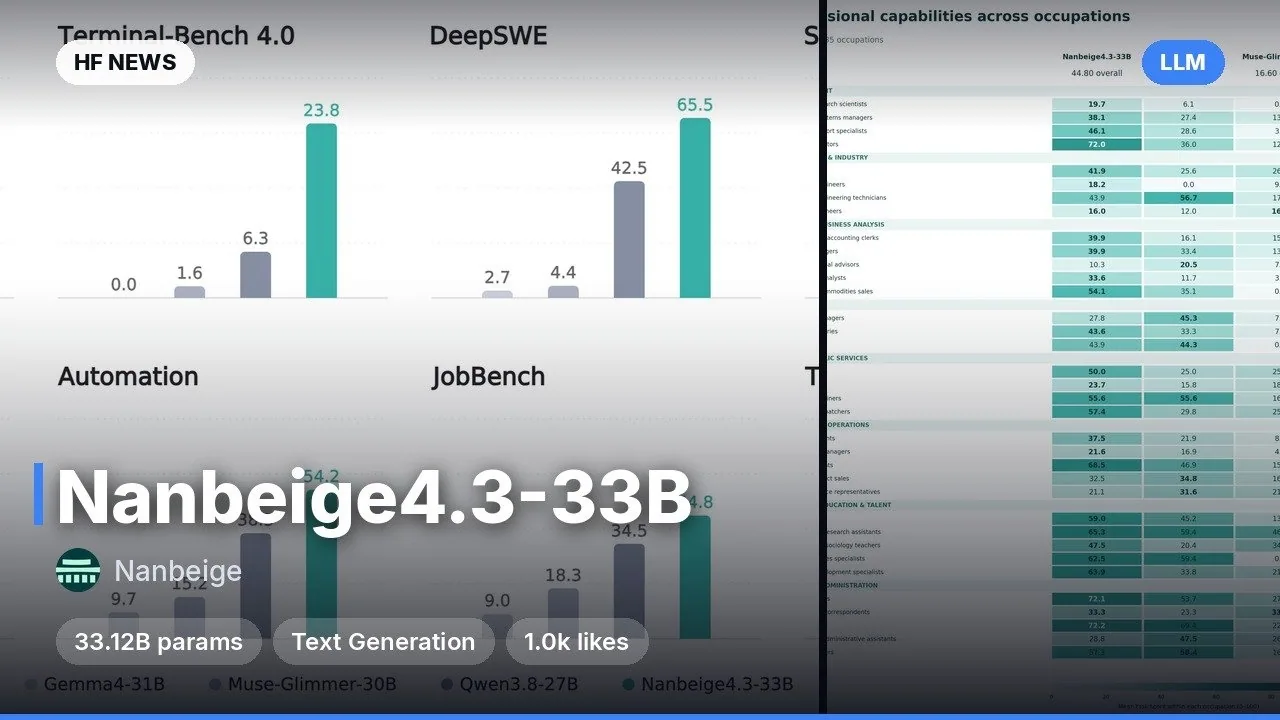
31B-модель, которая пишет как человек, но не теряет рабочие навыки
LessThanThreeAI выложила BF16-файнтюн google/gemma-4-31B-it для текстовой генерации. У модели 31,27 млрд параметров, лицензия Apache-2.0, веса под vLLM, SGLang и transformers. Системный промпт не обязателен.
Модель от tailot для super-resolution на архитектуре LIIF: один чекпойнт апскейлит RGB-изображение до произвольного целевого размера — 2x, 4x, 9.2x или явно заданных 3000 px. В модели 4.60 M параметров, tiled inference с
Leokani-tts от Milliwatt Labs — английская text-to-speech модель всего на 7.0M параметров, которая работает на обычном CPU, Raspberry Pi и даже ESP32. Говорит одним женским американским голосом, обученным на синтетическо
крошечная LLM с Peri-LN, Canon-слоями и гейтами внимания
Ethoric-10M — decoder-only языковая модель на 9,97 млн параметров от Tech.us. Архитектура сочетает RMSNorm, RoPE, GQA и SwiGLU, а также Peri-LN, короткие causal depthwise-свёртки Canon и headwise sigmoid gate. Обучена на
одна политика для ходьбы, сцен и восстановления Unitree G1
NVIDIA представила Metatron v1 — проект для интерактивного управления гуманоидом Unitree G1 с 29 управляемыми суставами, в первую очередь для браузерных демонстраций и G1 Racer. В основе — MaskedMimic-style transformer s
LoRA-адаптер для text-to-image от axiomofmind на базе briaai/Fibo-2.0-dev. Это checkpoint 400 из прогона fibo-anime-v1-pilot-400: адаптер обучен под anime- и seinen-иллюстрации с триггером fibo_seinen_style.
NorthCUA-Pro — крупнейшая модель семейства NorthCUA от beipo-ai: 397B параметров всего и 17B активных, mixture-of-experts на базе Qwen3.5. Она принимает запросы, скриншоты и историю взаимодействия, а выдаёт рассуждения,
Это abliterated-вариант LFM3-1.7B от Liquid AI: причинная языковая модель на tri-hybrid архитектуре, ~1.73B параметров и контекстом 262 144 токена. Сборка от Vortecks убирает направления отказов в activation space, поэто
Carbon-X-SFT от Hugging Face Bio — это chat-модель на 14,8 млрд параметров, обученная на последовательностях ДНК и тексте. Она принимает сырую ДНК прямо в диалоге и по-английски отвечает: оценивает патогенность мутаций,
davanstrien выпустил компактную модель решений для очистки и сортировки данных: она принимает текст и набор именованных вопросов, а возвращает вероятности по вариантам без генерации текста. В основе — энкодер UltraBERT-3