SmolVLA LangPush
управление роборукой по текстовой команде в симуляции
2 мин чтенияобновлено
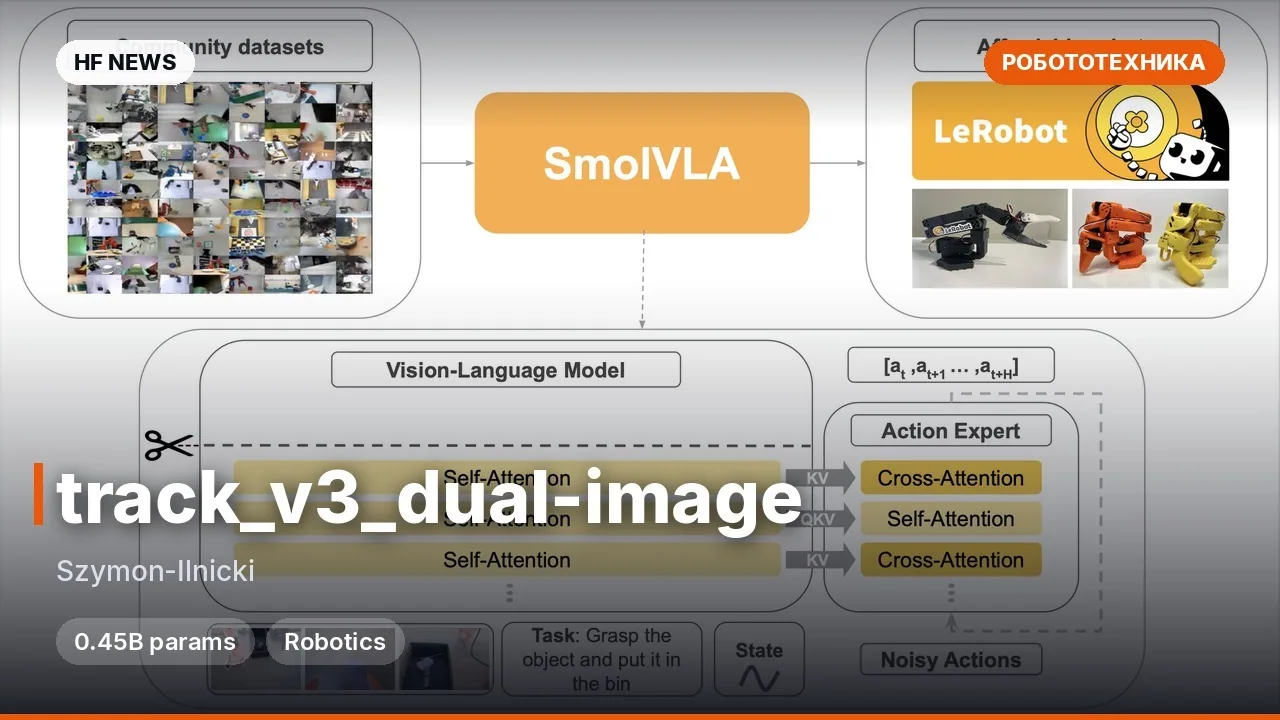
irodkin/smolvla-langpush-run11 — дообученная VLA-модель (Vision-Language-Action, нейросеть, связывающая зрение, текст и действия робота) на базе lerobot/smolvla_base размером 0.45B параметров. Она управляет толкателем на манипуляторе Seeed reBot Arm B601-RS с камерой на запястье в симуляторе MuJoCo. На вход подаётся изображение с камеры и текстовая инструкция — передвинуть красный или синий кубик в зелёную целевую зону, а на выходе модель генерирует траекторию движения инструмента. Авторы (команда ROB7103/8103 Embodied AI) добились того, что политика действительно опирается на название цвета в тексте, а не угадывает цель по начальной позе манипулятора, что пригодится исследователям в области робототехники и обучения с подкреплением.
Ключевые особенности
- Реальное следование тексту: модель различает команды для красного и синего кубика в 186 из 192 тестовых запусков (96.9% успеха) даже на симметричных сценах.
- Режим относительных действий (Delta mode): модель предсказывает смещение и поворот наконечника в его собственной системе координат, а в качестве состояния получает только направление гравитации.
- Точечное дообучение VLM: помимо модуля действий, в float32 дообучались верхние 8 слоёв визуально-языковой модели, что позволило связать слова с объектами в кадре.
- Высокая частота планирования: модель генерирует блоки по 50 действий на частоте 30 fps с обновлением плана каждые 10 кадров по данным с одной камеры.
Что можно сделать
- Протестировать политику управления манипулятором Seeed reBot Arm B601-RS в симуляции MuJoCo на задачах выбора объектов по цвету.
- Использовать подход с относительными координатами (delta mode) и разморозкой верхних слоёв VLM как референс при обучении собственных политик в библиотеке
lerobot.
Пример
from lerobot.policies.smolvla.modeling_smolvla import SmolVLAPolicy
policy = SmolVLAPolicy.from_pretrained("irodkin/smolvla-langpush-run11")
Подробнее
Метрики (192 теста): 186 успешных попыток (93/96 для красного и 93/96 для синего кубика), в 99% случаев первый план сразу ведёт к нужному кубику.Обучение: 30 000 шагов на 10 000 демо + 20 000 шагов с новым расписанием learning rate (batch size 64).
Ограничения: работает только в симуляции MuJoCo (не проверялась на реальном роботе), рассчитана строго на два кубика по 4 см, зелёную зону 6 см и управление в delta-режиме.


Комментарии