Другоеcasareborgia
Humanoid-v5 PPO
тюнингованный PPO для ходьбы
1 мин чтения
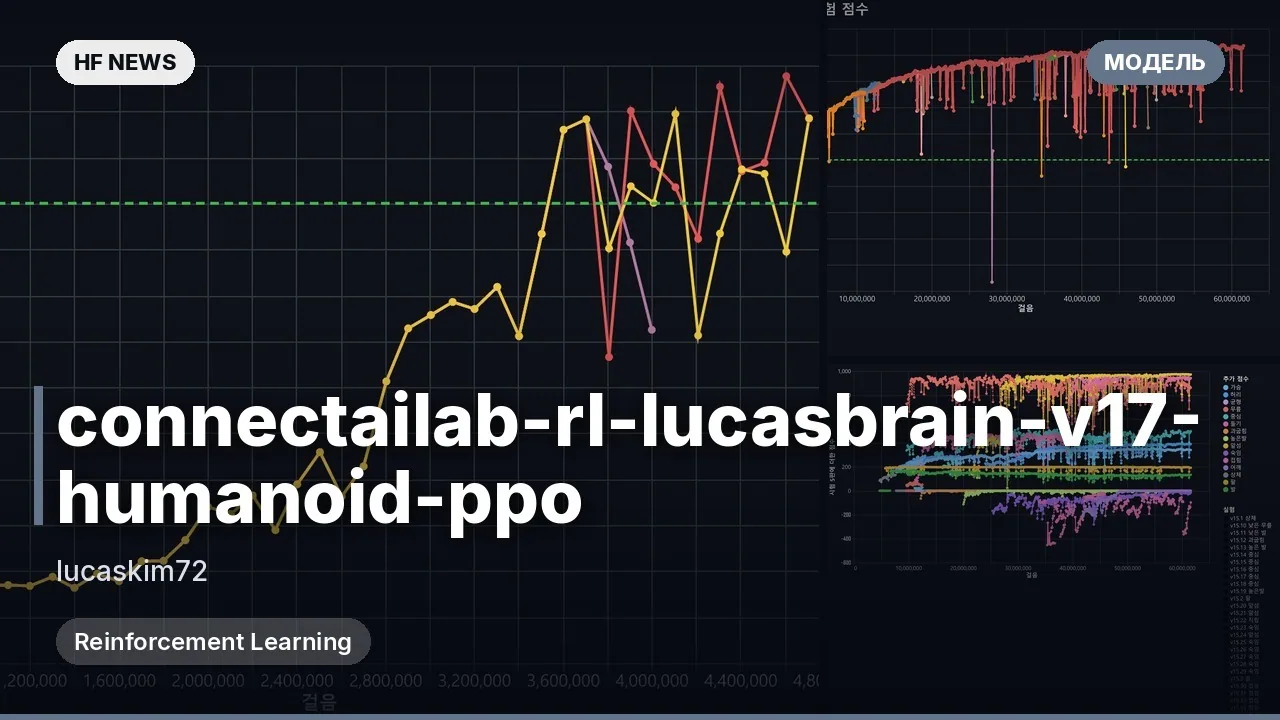
Это PPO-чекпоинт от casareborgia, который расширяет непрерывный PPO из 6-го урока RL на MuJoCo Humanoid-v5: 348 состояний и 17 суставных моторов. Гиперпараметры подобраны под задачу устойчивой ходьбы.
⚙ Ключевые особенности
- 🎯 Среда MuJoCo
Humanoid-v5: 348 наблюдений и 17 моторов. - ⚙ Сеть расширена до
hidden=384;init log stdснижен до -1.2 для точного исследования в диапазоне суставов [-0.4, +0.4]. - 🚀 Тюнингованный PPO: 32×256 сэмплов на обновление, mini-batch 1024, γ=0.995, λ=0.97, clip ε=0.15.
- 💻 В комплекте
model.pt, политика и параметры нормализации наблюдений. - 🔆 Результат: 500 шагов (полный проход) и 2792.5 награды; среднее по 10 прогонам — 2012.1.
💻 Пример
import torch
from huggingface_hub import hf_hub_download
from train_humanoid_tuned import 정책두뇌튜닝, 상태정규화

path = hf_hub_download("casareborgia/connectailab-rl-leeseungjun-ver1-humanoid-ppo", "model.pt")
ckpt = torch.load(path, map_location="cpu", weights_only=False)
뇌 = 정책두뇌튜닝(348, 17, 은닉=384, 초기흔들림=-1.2)
뇌.load_state_dict(ckpt["model"])
Подробнее
Бенчмарк: случайная политика — 19 шагов и 87.2; базовый PPO (1 млн шагов) — 288 шагов, 1699.4 и +4.85 м; тюнингованный PPO (1.2 млн шагов) — 500 шагов, 2792.5 и +5.27 м.Средняя награда тюнингованного PPO по 10 прогонам — 2012.1.
Обучение: 1.2 млн шагов, hidden 384, 32×256 сэмплов, mini-batch 1024, γ=0.995, λ=0.97, clip ε=0.15.
Заявлена только среда MuJoCo Humanoid-v5; аппаратные требования в карточке не указаны.


Комментарии