К содержимому
Видео

MiniMax-H3-Character-Swap-LoRA

замена персонажей на видео по референсу

2 мин чтенияобновлено

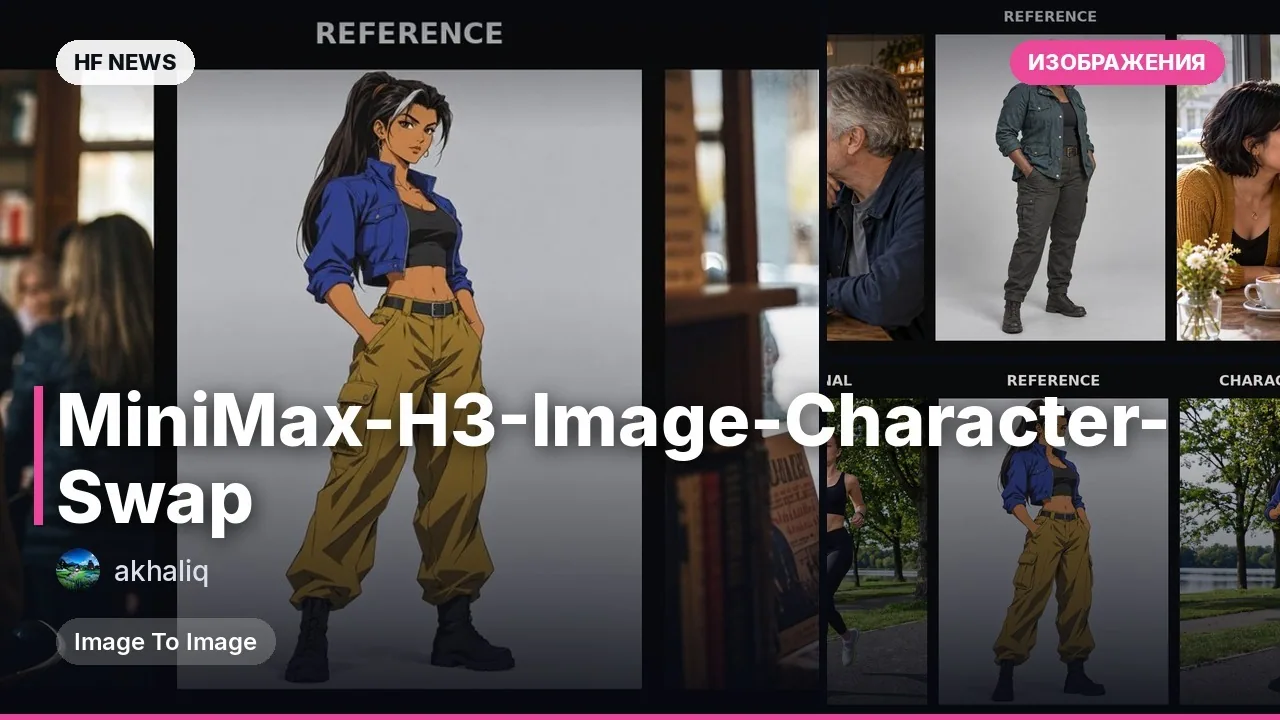
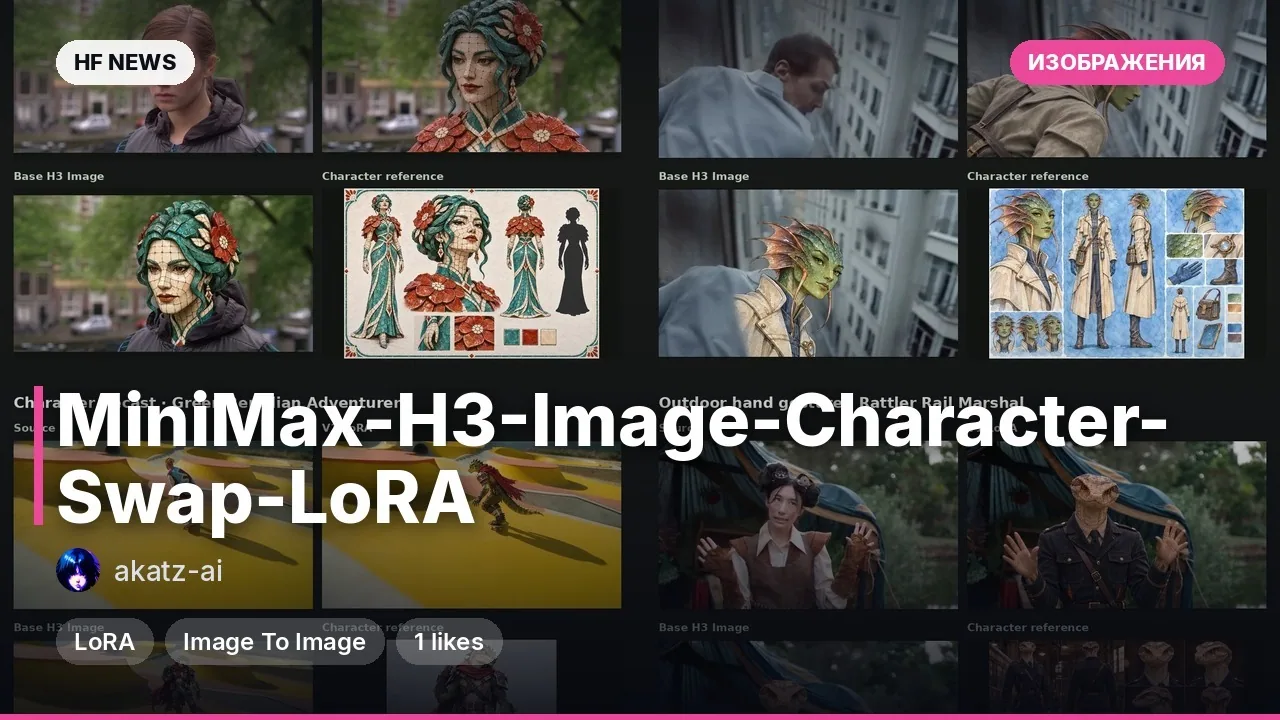
Адаптер в формате LoRA (небольшая надстройка над базовой моделью) от Akatz Labs для замены выбранного человека в исходном видео на персонажа с одного референсного изображения. Модель работает поверх базы MiniMax-H3 (вариант Ref2VA) и переносит лицо, причёску и одежду с картинки, сохраняя при этом позу, взгляд, мимику и движения актёра из ролика, а также фон и остальных людей в кадре. В актуальной версии V1.5 улучшено удержание стилизованных лиц и деталей внешности по сравнению с первой версией, где персонаж мог срываться обратно в исходный облик. Инструмент пригодится видеомейкерам, аниматорам и авторам контента, работающим с генерацией видео в ComfyUI.

Ключевые особенности

  • Версия V1.5 (h3_character_swap_v1.5.safetensors) рекомендуется как основная с весом (strength) 1.0, но в репозитории оставлена и V1 для воспроизводимости старых пайплайнов.
  • Нативная интеграция в ComfyUI через воркфлоу H3 Relay 2.0 с поддержкой сегментации масками через SAM, циклов и таймлайн-помощников.
  • Поддержка ускоренного пайплайна на 8 шагах при использовании с базой Ref2VA INT8 и отдельным ускорителем minimax_h3_fl2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors.
  • Улучшенное сохранение идентичности сложных и стилизованных персонажей в динамичных сценах по сравнению с релизом V1.

Что можно сделать

  • Заменить актёра в коротком непрерывном дубле (24 fps) на собственного вымышленного или стилизованного персонажа с сохранением оригинальной актёрской игры.
  • Встроить персонажа с концепт-арта в живую сцену с несколькими людьми, не перерисовывая окружение и второстепенных героев.
  • Протестировать быструю итерацию роликов в разрешение 768p на 8 шагах (сэмплер er_sde, CFG 1) перед финальной доработкой длинных сцен.

Пример

Сценарий запуска в ComfyUI: на вход подаётся исходный ролик (), референсное изображение персонажа () и текстовый промпт:
«Replace the selected person in with the character in . Keep the reference character's face, hair and clothing. Follow the source performance's pose, gaze, expression and movement. Preserve the scene and the other people.»

Подробнее Рекомендуемый чекпоинт V1.5 дообучен на 1 000 дополнительных шагах поверх V1.
Проверенный рецепт запуска: база Ref2VA INT8 + LoRA (strength 1.0) + Turbo-модель (strength 1.0), 8 шагов, CFG 1, планировщик er_sde / normal.
Ограничения: модель экспериментальная, на сложных перекрытиях, склейках и длинных планах возможен дрейф мимики и внешности; аудиодорожка сохраняется средствами приложения, точный липсинк не гарантируется.
Лицензия: MiniMax H3 Community License Agreement.

Видео-примеры
Обсудить Telegram 0 19

Запустится ли?

Только с выгрузкой в ОЗУ

Даже 4-bit больше видеопамяти. Часть слоёв можно держать в оперативной памяти (llama.cpp, ComfyUI), но работать будет в разы медленнее.

  • BF16веса 122 GB · готовые файлы144 GB
  • FP8 / INT8рекомендуемвеса 61 GB74 GB
  • 4-bitвеса 35 GB43 GB

Совет: берите 8-bit.FP8 / INT8 почти не отличается по качеству от полной точности (разница в пределах процента), а памяти занимает вдвое меньше и на RTX 40/50, H100 работает быстрее. Полную точность есть смысл брать только для дообучения.

Что взять под эту модель

Massed ComputeОткрыть Massed Compute

Своя видеокарта: В домашние видеокарты не поместится — выгоднее арендовать.

Почасовые цены Massed Compute на ноябрь 2026. Цена со скидкой — с промокодом при оплате.

Это LoRA: вместе с базовой моделью MiniMax-H3.

Оценка: веса плюс рабочая память. Длинные ролики, высокое разрешение и большой контекст требуют больше.

Запуск на Massed Compute

Скрипт скачает модель на арендованную машину. Как её запустить — в карточке модели.

  1. 1. Арендуйте машину с подходящей видеокартой

    Открыть Massed Compute
  2. 2. Вставьте скрипт в терминал машины

    Подключитесь по SSH (команда есть в панели Massed Compute) или откройте терминал на рабочем столе машины.

    HF_TOKEN / CIVITAI_TOKENВ начале скрипта строки для токенов: вставьте свой между кавычками. Токен Hugging Face нужен для закрытых моделей, токен Civitai — для моделей с Civitai.

    # Jirimbinha/MiniMax-H3-Character-Swap-LoRA
    mkdir -p ~/models
    curl -LsSf https://astral.sh/uv/install.sh | sh
    source "$HOME/.local/bin/env"
    uv tool install "huggingface_hub[cli]"
    hf download Comfy-Org/MiniMax-H3 --local-dir ~/models/MiniMax-H3
    hf download Jirimbinha/MiniMax-H3-Character-Swap-LoRA --local-dir ~/models/MiniMax-H3-Character-Swap-LoRA
    # Модель в папке ~/models. Как её запускать, написано в карточке модели (ссылка выше).
    Добавить ещё LoRA к MiniMax-H3
  3. 3. Пользуйтесь

    Модель в папке ~/models. Как её запускать, написано в карточке модели (ссылка выше).

Не забудьте остановить машину в панели, когда закончите: оплата идёт поминутно, пока она включена.

Как ускорить

Подобрано под тип модели. Выберите своё железо в блоке выше — покажем то, что подходит именно вам.

  • SageAttention 3v2.2.0от 28 октября 2025

    ещё быстрее на RTX 50 / Blackwell

    FP4-внимание для Blackwell. Быстрее SageAttention 2, но авторы советуют 2-ю версию, когда важна точность.

    Как включить: Сборка из папки sageattention3_blackwell репозитория; в ComfyUI — через KJNodes.

    Предыдущие поколения (2)
    • SageAttention 2++ — Квантованное (INT8/FP8) внимание без заметной потери качества. Главное ускорение для генерации картинок и видео.
    • SageAttention 1 — Первая версия: INT8 для Q·K. Работает и на старых сборках, но 2++ быстрее и точнее.
  • FlashAttention 44.0.0b40от 18 ноября 2026новая версия

    самое быстрое точное внимание на B200

    Ядра для Blackwell (пока бета). Точное внимание без квантования — подходит для всего, включая LLM.

    Как включить: pip install flash-attn-4; vLLM и SGLang подхватывают сами.

    Предыдущие поколения (3)
    • FlashAttention 3 — Версия для Hopper (H100/H200) с FP8.
    • FlashAttention 2 — Стандарт для RTX 30/40/50 и A100: точное внимание без лишней памяти на длинных контекстах.
    • xFormers — Старый способ ускорить внимание, работает почти везде. Если есть Sage или Flash — они быстрее.
  • cache-dit (DBCache)v1.5.6от 20 ноября 2026новая версия

    1.5–3× при почти том же качестве

    Переиспользует результаты блоков между шагами диффузии. Поддерживает большинство DiT-моделей.

    Как включить: pip install cache-dit; одна строка cache_dit.enable_cache(pipe) для diffusers.

    Предыдущие поколения (2)
    • MagCache — Пропускает шаги по величине изменений. Точнее TeaCache без калибровки.
    • TeaCache — Первый массовый кэш шагов диффузии. Работает, но новые методы точнее.
  • LightX2V step distill0.6.1от 9 ноября 2026новая версия

    5–10× меньше шагов

    Дистиллированные LoRA и движок: видео за 4–8 шагов вместо 30–50.

    Как включить: Подключите их step-distill LoRA к модели, CFG 1.0, 4–8 шагов.

  • torch.compile2.15.0от 28 октября 2026новая версия

    10–30% бесплатно

    Компилирует модель под вашу видеокарту. Первый запуск дольше, дальше быстрее.

    Как включить: model = torch.compile(model); в ComfyUI — узел TorchCompileModel.

Промпты для MiniMax H3

Все промпты

Готовые промпты с видео результата: копируйте и пробуйте.

Семья модели

Нужна базовая модель

Comfy-Org/MiniMax-H3

Эта модель — LoRA / адаптер. Сначала скачайте базовую модель, затем подключите к ней эту.

  1. MiniMax-H3основа семьи
  2. MiniMax-H3
  3. MiniMax-H3-Character-Swap-LoRA

Новые посты про версии MiniMax-H3 — сжатые, дообучения, LoRA — появятся в колокольчике.

Сжатые версии 12Все на Hugging Face
Дообучения 12Все на Hugging Face
LoRA и адаптеры 12Все на Hugging Face
Слияния 3Все на Hugging Face

О модели

Jirimbinha/MiniMax-H3-Character-Swap-LoRA
Автор
Jirimbinha
Категория
Видео
Дата выхода
На сайте

На сайте

Hugging Face

190

Спросить нейросеть об этой модели

Отвечает Gemini 4 · переписка хранится только в этой вкладке

Комментарии