mT5 Lugbara/Luganda→English translator
перевод для низкоресурсных языков
2 мин чтения
Это файнтюн google/mt5-base (0,58 млрд параметров) от автора ckuma для перевода с лугбара и луганда на английский. Модель обучена по методике диссертации C. D. Akuma (Muni University, 2025) на случайной выборке из Sunbird SALT того же размера, что корпус диссертации: 15 524 пары, разбиение 70/15/15.
Ключевые особенности
- Seq2seq-файнтюн mT5-base для двух направлений: Lugbara→English и Luganda→English.
- В карточке для обоих направлений указан тег
<2en>; текст нужно подавать в lowercase. - Препроцессинг: нижний регистр, нормализация пунктуации, сведение вариантов апострофов к
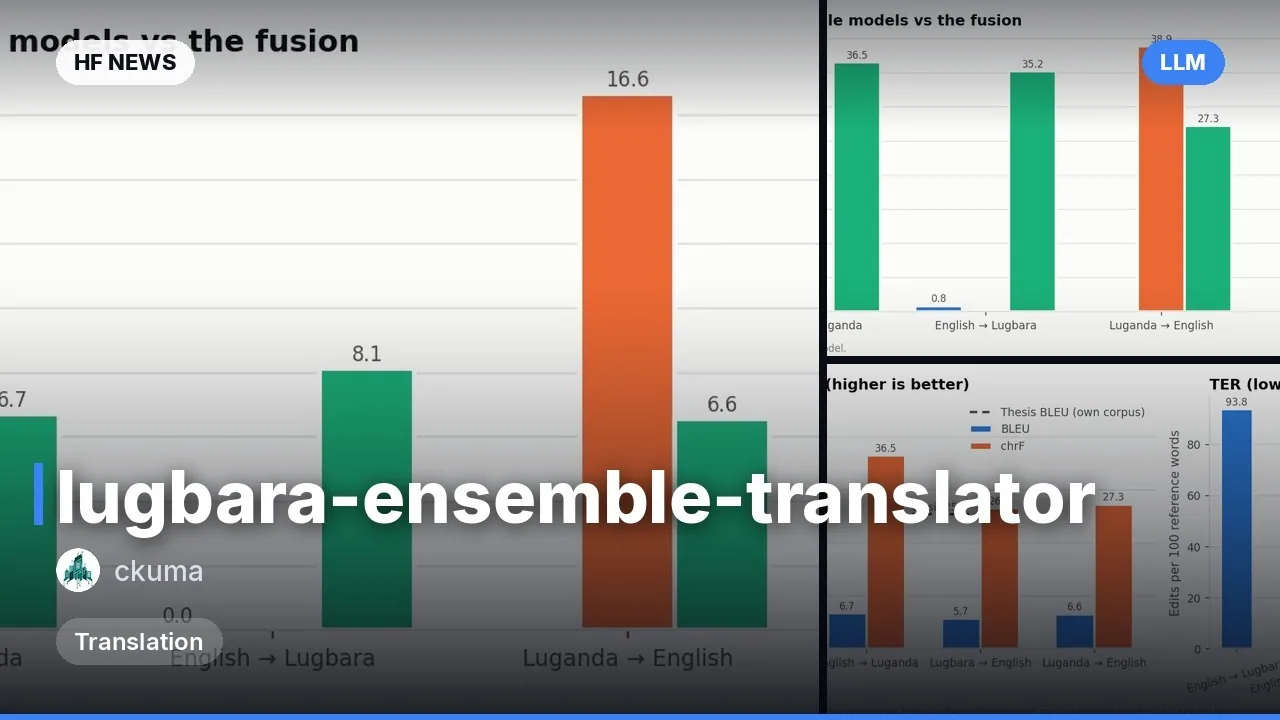
', удаление пустых/дублирующихся/битых пар. - На тесте: BLEU 12,71 и 16,65; TER 73,47 и 67,81; chrF 34,73 и 38,88 для Lugbara→EN и Luganda→EN соответственно.
- Обучение на коротких предложениях SALT (сельское хозяйство, здоровье, общество), другие домены слабее; тон в лугбара не пишется и теряется.
Пример
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM
tok = AutoTokenizer.from_pretrained('ckuma/lugbara-english-translator')
model = AutoModelForSeq2SeqLM.from_pretrained('ckuma/lugbara-english-translator')
def translate(text, tag):
    x = tok(tag + ' ' + text.lower(), return_tensors='pt')
    y = model.generate(**x, num_beams=4, max_new_tokens=128)
    return tok.decode(y[0], skip_special_tokens=True)
print(translate('ba erini tutuni ...', '<2en>'))
Подробнее
BLEU: 12,71 Lugbara→EN и 16,65 Luganda→EN; TER 73,47/67,81; chrF 34,73/38,88.Обучение: lr 0.001, batch 16, adafactor, early stopping; 8 154 шага, около 83,5 мин на Kaggle GPU.
Ограничения: только короткие предложения SALT, lowercase, потеря тона; оценки по одному референсу — нужна проверка носителем.
База: google/mt5-base; данные: Sunbird SALT (CC BY-SA 4.0).


Комментарии