Xiaomi-OCR-0-vi
OCR для вьетнамских документов
2 min read
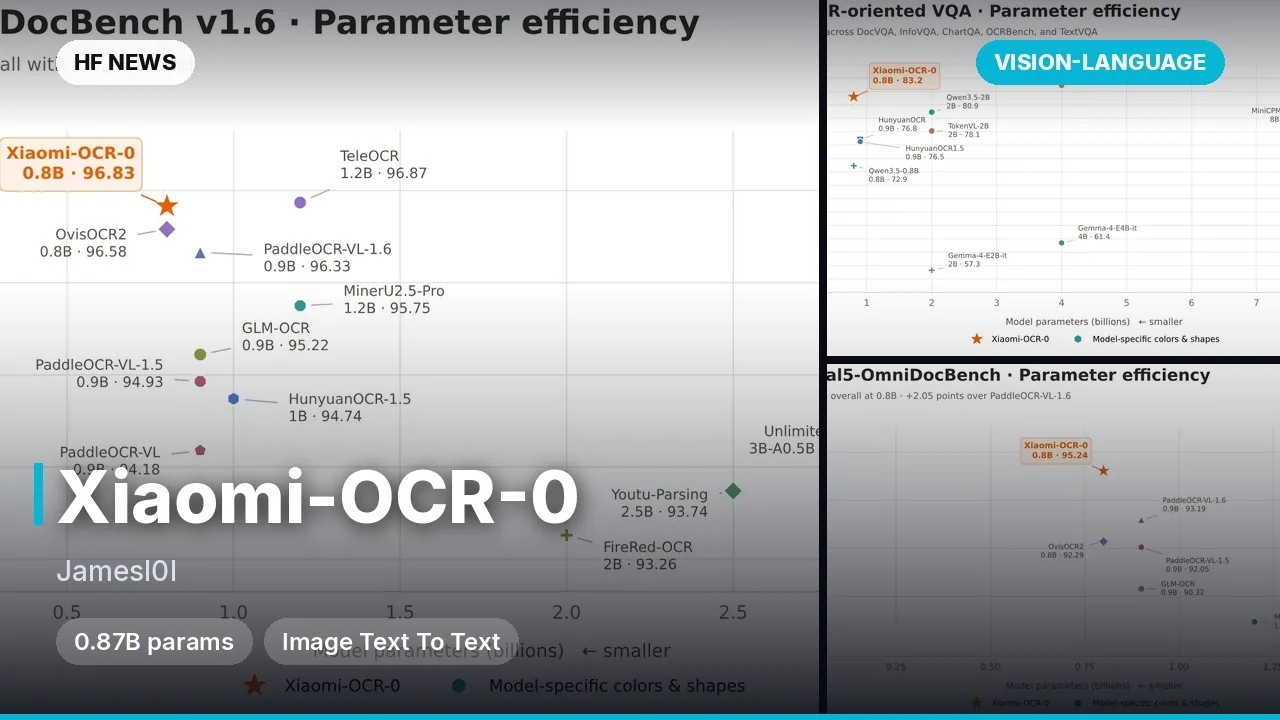
Xiaomi-OCR-0-vi — это OCR-модель на базе Xiaomi-OCR-0 (0.8B), дообученная под вьетнамский язык: официальные письма (công văn), фото документов с телефона, таблицы и старопечатные тексты. Личный учебный проект автора nhtera. В репозитории лежит merged-модель, которая загружается как базовая, и LoRA-адаптер отдельно.
Ключевые особенности
- База — Xiaomi-OCR-0 (0.8B); дообучение под вьетнамский: документы, таблицы, фото и старая печать.
- В корне репозитория — merged-модель, в
adapter/— LoRA r32/α51.2 иemb_rows.safetensors. - Обучение примерно на 45k примерах: вьетнамские юридические и Wikipedia-страницы, line-датасеты, VinText, таблицы, фото английских страниц и 3,5k вычитанных сканов Wikisource.
- Финальные веса — r6-апдейт, сжатый к базе на 0.8 без дальнейшего обучения: вернул часть английского без потерь для вьетнамского.
- Лицензия CC-BY-NC-4.0: только исследования и личное использование — часть тренировочных данных non-commercial/research-only.
Пример
import torch
from PIL import Image, ImageOps
from transformers import AutoModelForImageTextToText, AutoProcessor

repo = "nhtera/Xiaomi-OCR-0-vi"
model = AutoModelForImageTextToText.from_pretrained(repo, dtype=torch.bfloat16, device_map="auto")
proc = AutoProcessor.from_pretrained(repo)
image = ImageOps.exif_transpose(Image.open("page.jpg")).convert("RGB")
Подробнее
MDPBench-VI digital: 88.1 / 89.5 (1-NED / bag-F1) против 76.2 / 45.3 у базы.Phone photos: 81.1 / 83.6; VN-Hard: 91.7 / 80; шапки công văn — 27 из 32.
Английский на чистых страницах близок к базе: 82.9 / 85.6, примерно на 2 пункта ниже.
Ограничения: фото с телефона — слабее всего; плотные Hán/Nôm — 50–70; бывают ошибки порядка шапки и путаница таблиц с абзацами.


Comments