Omoikane-50M-Base-Phase-1
компактная гибридная LLM, обученная на Mac mini
2 min readupdated
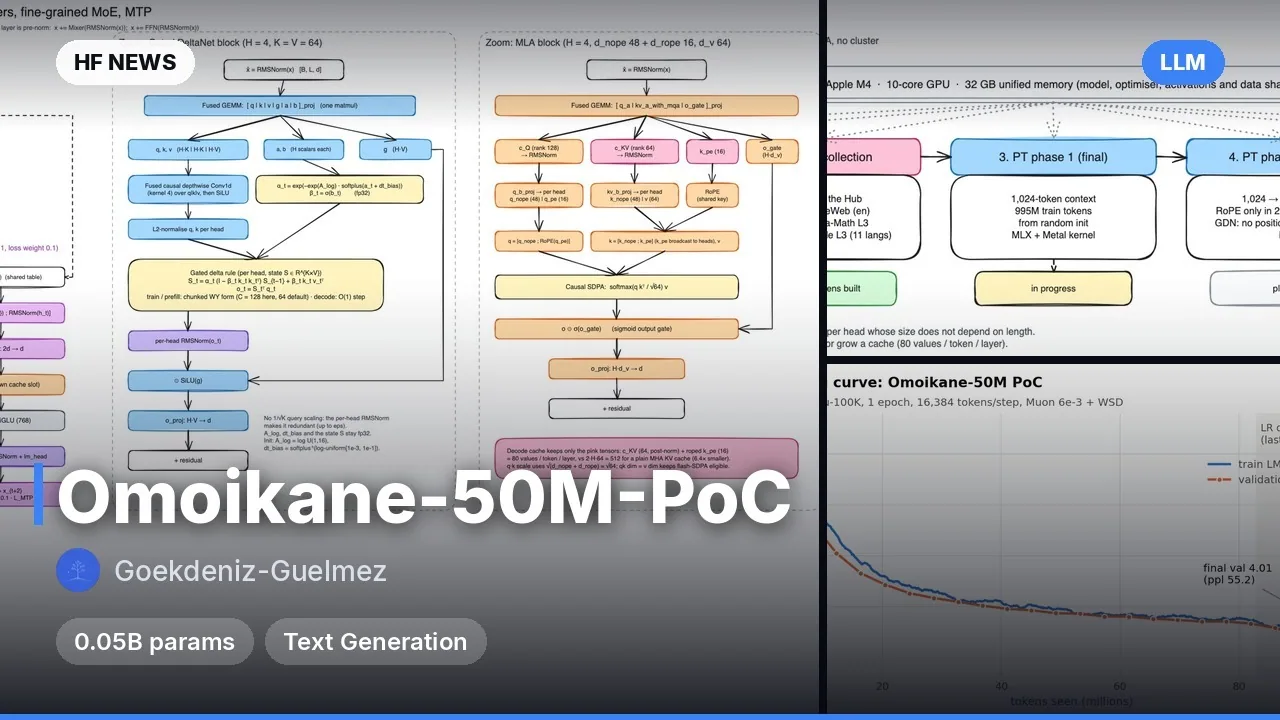
Базовая языковая модель от автора Gökdeniz Gülmez на 48,9 млн параметров, созданная и обученная с нуля за 70,3 часа на одном Mac mini (Apple M4, 32 ГБ памяти) без использования CUDA. Внутри объединены рекуррентные слои Gated DeltaNet, сжатое внимание MLA (Multi-head Latent Attention), архитектура MoE (Mixture-of-Experts, смесь небольших экспертов) и голова MTP (предсказание сразу нескольких токенов вперёд). Модель обучена на 995 млн токенов английских текстов, математики и кода; она просто продолжает текст и не настроена на диалог в формате ассистента. Пригодится исследователям и энтузиастам для изучения гибридных архитектур, экспериментов с локальным запуском на Apple Silicon (через MLX) или дообучения под свои задачи.
Ключевые особенности
- Гибрид двух типов памяти: 8 из 10 слоёв — линейные рекуррентные Gated DeltaNet со скоростью O(1) на токен, а слои 3 и 7 используют внимание MLA со сжатым KV-кэшем для точного поиска по контексту.
- Мелкозернистый MoE и MTP: в слоях 1–8 работают 16 небольших экспертов (активируются топ-4 плюс 1 общий), а дополнительная голова предсказывает токен t+2, что даёт ускорение жадной генерации примерно в 1,3–1,5 раза.
- Две среды запуска: в репозитории лежат готовые реализации и для стандартного PyTorch (
transformers), и для фреймворка MLX под чипы Apple Silicon. - Запас по длине контекста: несмотря на обучение на окнах в 1 024 токена, функция потерь остаётся стабильной без дообучения на длине до 4 096 токенов.
Что можно сделать
- Запустить локально на Mac через MLX или на CPU/GPU через
transformersдля тестов скорости генерации и изучения работы рекуррентного кэшаOmoikaneCache. - Использовать как лёгкую базу для экспериментального SFT-дообучения (файнтюна под инструкции) или специализированных задач на английском языке.
- Разобрать исходный код
modeling_omoikane.pyиmodeling_omoikane_mlx.pyкак готовый пример связки Gated DeltaNet, MLA, оптимизатора Muon и MTP в одном компактном пайплайне.
Пример
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

repo = "Goekdeniz-Guelmez/Omoikane-50M-Base"
tok = AutoTokenizer.from_pretrained(repo, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(repo, trust_remote_code=True, dtype=torch.float32).eval()
out = model.generate(**tok("def fibonacci(n):\n", return_tensors="pt"), max_new_tokens=64, do_sample=True, temperature=0.8)
print(tok.decode(out[0], skip_special_tokens=True))
Подробнее
Бенчмарки (zero-shot): SciQ — 65.9%, PIQA — 55.0% (norm 57.5%), BLiMP — 71.3%, ARC-Easy — 39.4%.Обучение: 1 эпоха на 995M токенов (70% Ultra-FineWeb, 20% UltraData-Math, 10% UltraData-Code), 60 730 шагов с оптимизатором Muon и AdamW.
Ресурсы при обучении: Mac mini M4 (32 ГБ), пиковое потребление памяти 13,1 ГБ, медианная скорость 4 340 токенов/с.
Ограничения: только английский язык; из 48,9M параметров 33,6M приходится на словарь (131 072 токена) и лишь 15,4M на основной ствол, поэтому рассуждения слабые, а математика и код усвоены лишь на уровне формата.


Comments