Qwen3.8-27B-hermes-adapted-MLX-adapter
LoRA-адаптер для задач программирования под Apple Silicon
1 мин чтенияобновлено
Этот LoRA-адаптер (небольшая надстройка над базовой моделью) переносит возможности модели от harness-hub в формат библиотеки mlx-lm, чтобы запускать её на устройствах Apple Silicon. Модель обучена с помощью обучения с подкреплением (RL) для работы в составе Hermes Agent на задачах программной инженерии и работы с терминалом. Она позволяет значительно эффективнее справляться с кодингом и терминальными командами, используя меньше токенов и шагов. Адаптер пригодится разработчикам и пользователям Mac, которые хотят запускать производительные локальные агенты для написания кода.
Ключевые особенности
- Специализация на программной инженерии и работе в терминале
- Оптимизация под фреймворк mlx-lm для Mac
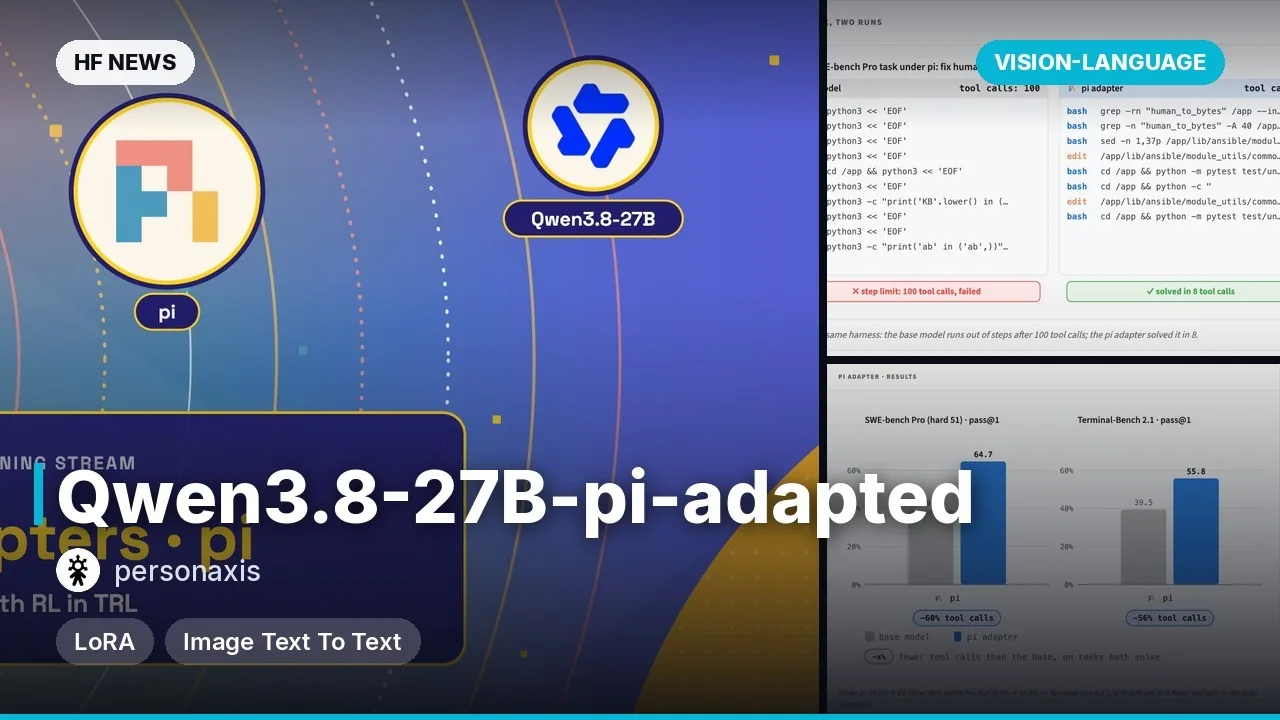
- Улучшение метрик на задачах SWE-bench Pro и Terminal-Bench
- Сокращение генерации токенов в сравнении с базовой моделью
Что можно сделать
- Применить в Hermes Agent для автоматизации инженерных задач
- Запустить через командную строку mlx_lm.server для локальной разработки
- Интегрировать в Python-скрипты с использованием mlx_lm
- Использовать адаптер поверх квантованных версий модели на Mac
Пример
from huggingface_hub import snapshot_download
from mlx_lm import load, generate

adapter = snapshot_download("netprojects/Qwen3.8-27B-hermes-adapted-MLX-adapter")
model, tokenizer = load("mlx-community/Qwen3.8-27B-4bit", adapter_path=adapter)
prompt = tokenizer.apply_chat_template([{"role": "user", "content": "Hello"}], add_generation_prompt=True,
                                       enable_thinking=False, tokenize=False)
print(generate(model, tokenizer, prompt=prompt, max_tokens=200))
Подробнее
• SWE-bench Pro (hard 51): 29.4% → 43.1%• Terminal-Bench 2.1: 44.7% → 58.8%
• Размер адаптера: 638 МБ
• Лицензия: Apache-2.0


Комментарии