К содержимому
Компьютерное зрение

Qwen3.8-27B-Coder390-EXL3-3.85bpw

27B кодер с vision и контекстом 262k на одной RTX 3090

2 мин чтенияобновлено

Квантизованная версия мультимодальной модели Qwen3.8-27B-Coder390 в формате EXL3 (сжатие весов для видеокарт NVIDIA, в среднем 3.85 бита на параметр) от исследователей из Автономного университета Барселоны (JRamirez-UAB). Она решает задачи программирования, рассуждений и анализа изображений, позволяя развернуть тяжёлую модель на одной потребительской карте с 24 ГБ видеопамяти. В отличие от многих обрезанных сборок, здесь сохранены модуль зрения (6 бит) и MTP (Multi-Token Prediction — спекулятивное декодирование на 3 токена вперёд для ускорения генерации). Пригодится разработчикам, которые запускают локальных ИИ-агентов и ассистентов для кода.

Ключевые особенности

  • Точное сжатие 3.85 bpw: основные веса сжаты до 3.85 бита, голова модели — до 5 бит, модуль зрения — до 6 бит, а эмбеддинги токенов — до 8 бит.
  • Полный контекст 262 144 токена: модель умещается в 24 ГБ VRAM вместе с KV-кэшем (k8v4) и поддержкой до 8 изображений на запрос.
  • Высокая скорость с MTP: спекулятивное декодирование на 3 токена даёт 86 ток/с в один поток и до 248 ток/с при 4 параллельных запросах на RTX 3090.
  • Минимальная потеря качества: расхождение (KLD) с оригинальной BF16-версией составляет всего 0.0089 на реальных агентских сценариях opencode.

Что можно сделать

  • Запустить локального ИИ-агента для кода: подключить модель через vLLM к инструментам вроде opencode — в тестах она безошибочно отработала 30/30 вызовов инструментов и 10/10 агентских задач.
  • Анализировать скриншоты и схемы с кодом: благодаря сохранённому vision-модулю можно отправлять модели интерфейсы, диаграммы и длинные репозитории до 262k токенов.

Пример

vllm serve JRamirez-UAB/Qwen3.8-27B-Coder390-EXL3-3.85bpw \
  --served-model-name coder390 --max-model-len 262144 \
  --kv-cache-dtype k8v4_per_token_head --kv-cache-memory-bytes 8500000000 \
  --limit-mm-per-prompt '{"image": 8}' --reasoning-parser qwen3 \
  --enable-auto-tool-choice --tool-call-parser qwen3_coder \
  --speculative-config '{"method":"mtp","num_speculative_tokens":3}'
ПодробнееЖелезо и софт: протестировано на одной RTX 3090 (24 ГБ VRAM, CUDA sm_86) в vLLM 0.33 с плагином quantpack 0.1.5.
Бенчмарки на RTX 3090: Vision 15/15, Reasoning 18/18, поиск в контексте (Needle) на 64k/128k/241k — 8/8, игровые задачи по коду — 42/48 баллов.
Важное ограничение: при низкой температуре модель склонна зацикливаться в рассуждениях (при T=0.6 зациклились 8 из 30 промптов, при T=1.0 — 0 из 30). Используйте штатный конфиг: temperature=1.0, top_p=0.95, top_k=20.


Обсудить Telegram 0 12

Запустится ли?

Запустится в I16

Влезает без сжатия.

  • I16веса 14 GB · готовые файлы15 GB
  • FP8 / INT8рекомендуемвеса 7.4 GB8.6 GB
  • 4-bitвеса 4.2 GB5.1 GB

Совет: берите 8-bit.FP8 / INT8 почти не отличается по качеству от полной точности (разница в пределах процента), а памяти занимает вдвое меньше и на RTX 40/50, H100 работает быстрее. Полную точность есть смысл брать только для дообучения.

Что взять под эту модель

Massed ComputeОткрыть Massed Compute

Своя видеокарта: FP8 / INT8 — от RTX 3080 · I16 — от RTX 5080

Почасовые цены Massed Compute на ноябрь 2026. Цена со скидкой — с промокодом при оплате.

Оценка: веса плюс рабочая память. Длинные ролики, высокое разрешение и большой контекст требуют больше.

Запуск на Massed Compute

Скрипт скачает модель на арендованную машину. Как её запустить — в карточке модели.

  1. 1. Арендуйте машину с подходящей видеокартой

    Открыть Massed Compute
  2. 2. Вставьте скрипт в терминал машины

    Подключитесь по SSH (команда есть в панели Massed Compute) или откройте терминал на рабочем столе машины.

    HF_TOKEN / CIVITAI_TOKENВ начале скрипта строки для токенов: вставьте свой между кавычками. Токен Hugging Face нужен для закрытых моделей, токен Civitai — для моделей с Civitai.

    # JRamirez-UAB/Qwen3.8-27B-Coder390-EXL3-3.85bpw
    mkdir -p ~/models
    curl -LsSf https://astral.sh/uv/install.sh | sh
    source "$HOME/.local/bin/env"
    uv tool install "huggingface_hub[cli]"
    hf download JRamirez-UAB/Qwen3.8-27B-Coder390-EXL3-3.85bpw --local-dir ~/models/Qwen3.8-27B-Coder390-EXL3-3.85bpw
    # Модель в папке ~/models. Как её запускать, написано в карточке модели (ссылка выше).
    Добавить ещё LoRA к Qwen3.8-27B-Coder390-EXL3-3.85bpw
  3. 3. Пользуйтесь

    Модель в папке ~/models. Как её запускать, написано в карточке модели (ссылка выше).

Не забудьте остановить машину в панели, когда закончите: оплата идёт поминутно, пока она включена.

Как ускорить

Подобрано под тип модели. Выберите своё железо в блоке выше — покажем то, что подходит именно вам.

  • FlashAttention 44.0.0b40от 18 ноября 2026новая версия

    самое быстрое точное внимание на B200

    Ядра для Blackwell (пока бета). Точное внимание без квантования — подходит для всего, включая LLM.

    Как включить: pip install flash-attn-4; vLLM и SGLang подхватывают сами.

    Предыдущие поколения (2)
    • FlashAttention 3 — Версия для Hopper (H100/H200) с FP8.
    • FlashAttention 2 — Стандарт для RTX 30/40/50 и A100: точное внимание без лишней памяти на длинных контекстах.
  • torch.compile2.15.0от 28 октября 2026новая версия

    10–30% бесплатно

    Компилирует модель под вашу видеокарту. Первый запуск дольше, дальше быстрее.

    Как включить: model = torch.compile(model); в ComfyUI — узел TorchCompileModel.

Семья модели

  1. Qwen3.8-27B-EfficientThink-Uncensored-K3-Opus5-Grok4.6-GPT5.6Sol-SFT-SimPO-DFlash2основа семьи
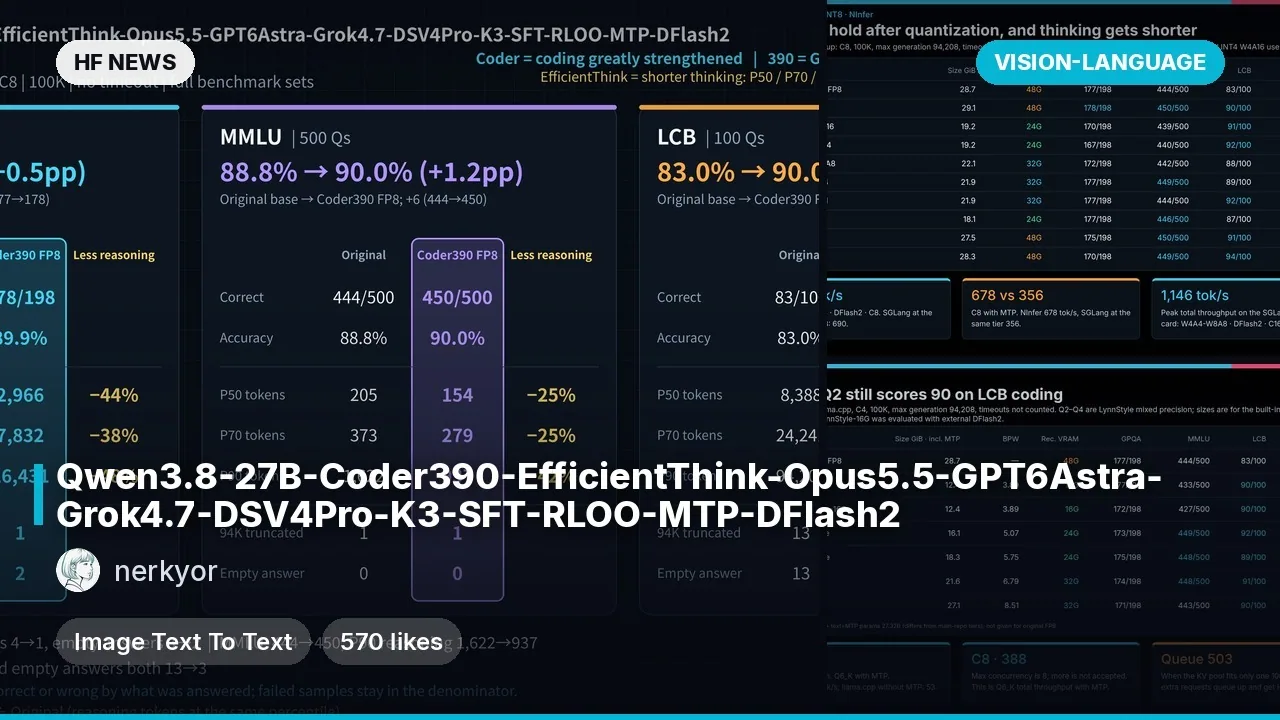
  2. Qwen3.8-27B-Coder390-EfficientThink-Opus5.5-GPT6Astra-Grok4.7-DSV4Pro-K3-SFT-RLOO-MTP-DFlash2
  3. Qwen3.8-27B-Coder390-EXL3-3.85bpw

Новые посты про версии Qwen3.8-27B-EfficientThink-Uncensored-K3-Opus5-Grok4.6-GPT5.6Sol-SFT-SimPO-DFlash2 — сжатые, дообучения, LoRA — появятся в колокольчике.

Сжатые версии 8Все на Hugging Face
Дообучения 2Все на Hugging Face

О модели

JRamirez-UAB/Qwen3.8-27B-Coder390-EXL3-3.85bpw
Автор
JRamirez-UAB
Категория
Компьютерное зрение
Дата выхода
На сайте

На сайте

Hugging Face

120

Спросить нейросеть об этой модели

Отвечает Gemini 4 · переписка хранится только в этой вкладке

Комментарии