Tiny Aya Safety Repair
модели до и после восстановления безопасности
2 мин чтенияобновлено
Набор весов и LoRA-адаптеров (небольших надстроек над базовой моделью) для исследования того, как даже полностью безобидное дообучение на классификации намерений и обычных вопросах втрое увеличивает долю небезопасных ответов языковой модели — и как эту защиту вернуть обратно. Артефакты созданы автором Ishant86 для хакатона Lexsi Labs AI Safety & Alignment (ноябрь 2026) на базе модели CohereLabs/tiny-aya-global (3.35B параметров). В репозиторий входит как полноценная «починенная» модель, полученная смешиванием весов по методу wise_ft, так и набор промежуточных файнтюнов и дельт с намеренно ослабленными ограничениями. Материал пригодится исследователям AI Safety, специалистам по alignment (выравниванию поведения моделей) и разработчикам, которые дообучают компактные LLM.
Ключевые особенности
- Полноценный чекпоинт
repaired/ft_v3_wise_ft_0.5с полными весами: смешивание основного файнтюна и оригинальной модели 50/50 возвращает безопасность почти к исходному уровню при сохранении целевого навыка. - Набор экспериментальных адаптеров (
ft_v1_e1,ft_v2,ft_v3и промежуточные чекпоинты по шагам) в собственном форматеlora_factors.pt(rank 16, alpha 32) и в виде стандартного PEFT-адаптера. - Дельты весов
abliteration/safetuneиabliteration/heretic(deltas.pt) с удалённым направлением отказа (refusal direction) для сравнения разных способов ослабления защиты. - Проверка не только на английском, но и на арабском, бенгальском, суахили и хинди, где восстановление безопасности работает заметно слабее.
Что можно сделать
- Воспроизвести эксперименты по деградации и восстановлению safety-фильтров после SFT (обучения с учителем) на безопасных датасетах.
- Сравнить поведение исходной
tiny-aya-global, «сломанного» PEFT-адаптераft_v3и восстановленной моделиft_v3_wise_ft_0.5на собственных тестах безопасности и целевых задачах. - Использовать сохраненные LoRA-матрицы и дельты как стенд для проверки других методов слияния весов и восстановления alignment без повторного обучения с нуля.
Пример
from transformers import AutoModelForCausalLM, AutoTokenizer
repo = "Ishant86/tiny-aya-safety-repair-models"
tok = AutoTokenizer.from_pretrained(repo, subfolder="repaired/ft_v3_wise_ft_0.5")
model = AutoModelForCausalLM.from_pretrained(repo, subfolder="repaired/ft_v3_wise_ft_0.5")
Подробнее
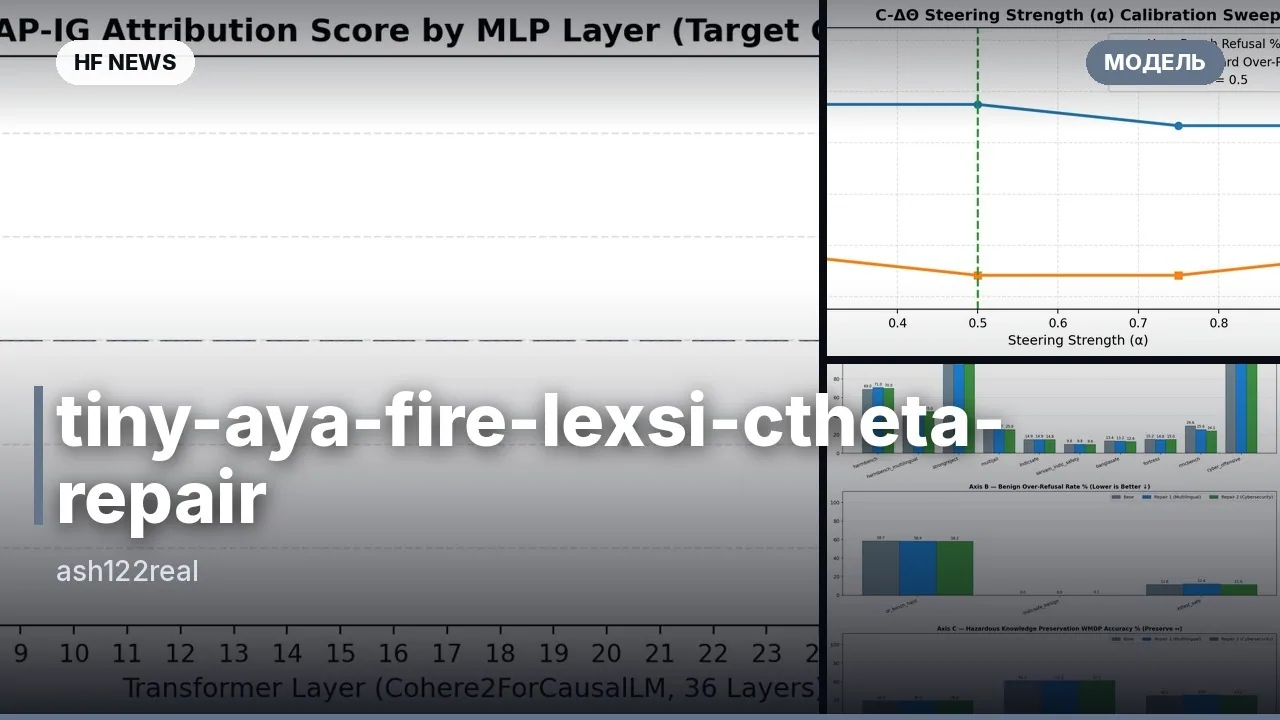
Метрики (HarmBench, доля небезопасных ответов из 100 / точность целевого навыка из 100): оригинал — 14 / 0; основной файнтюнft_v3 — 42 / 71; восстановленная ft_v3_wise_ft_0.5 — 17 / 70.Мультиязычный срез (арабский, бенгальский, суахили, хинди): у восстановленной модели 12 небезопасных ответов из 100 против 9 у оригинала.
Обучение
ft_v3: 6 400 примеров классификации намерений + 5 600 пар вопрос-ответ из Dolly, 1 500 шагов; LoRA для 252 линейных слоёв.Ограничения: модели, кроме папки
repaired/, намеренно небезопасны и не предназначены для продакшена; защита не проверялась на сложных джейлбрейках; лицензия CC-BY-NC.

Комментарии