К содержимому
Изображения

1125-Krea2Turbo-Asian-Utopian

реалистичные портреты за 8 шагов

3 мин чтенияобновлено

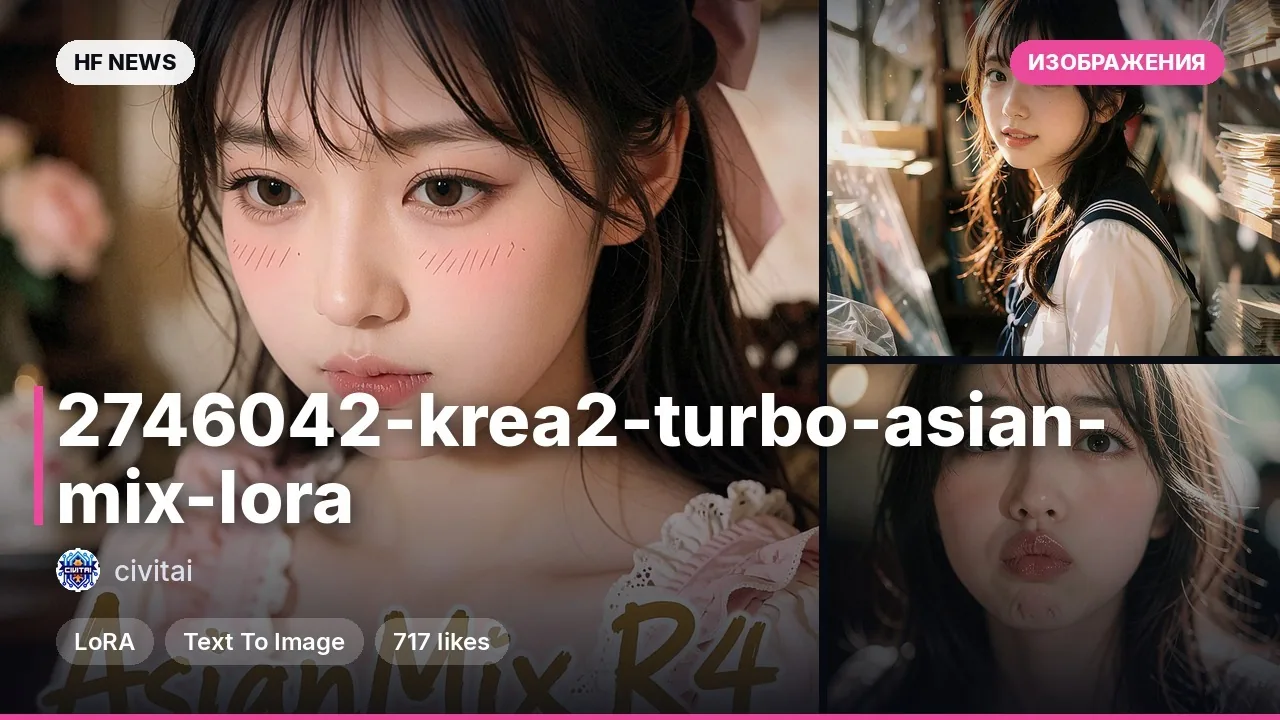
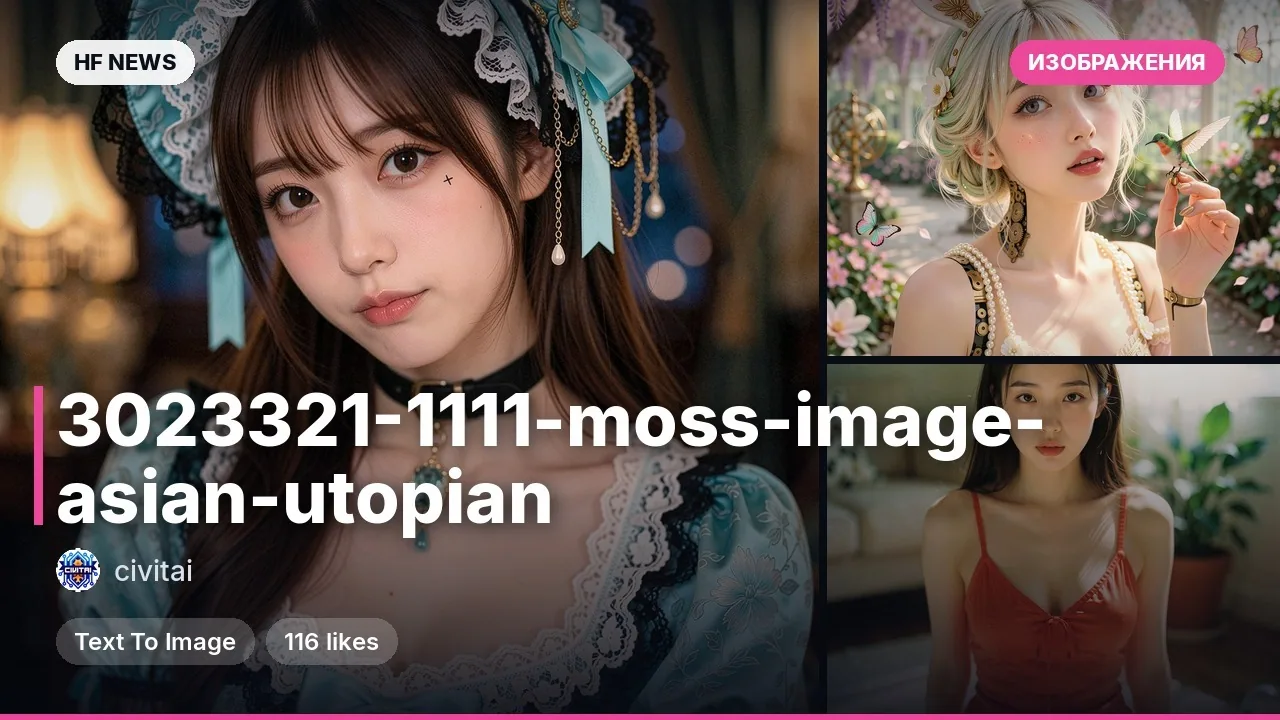
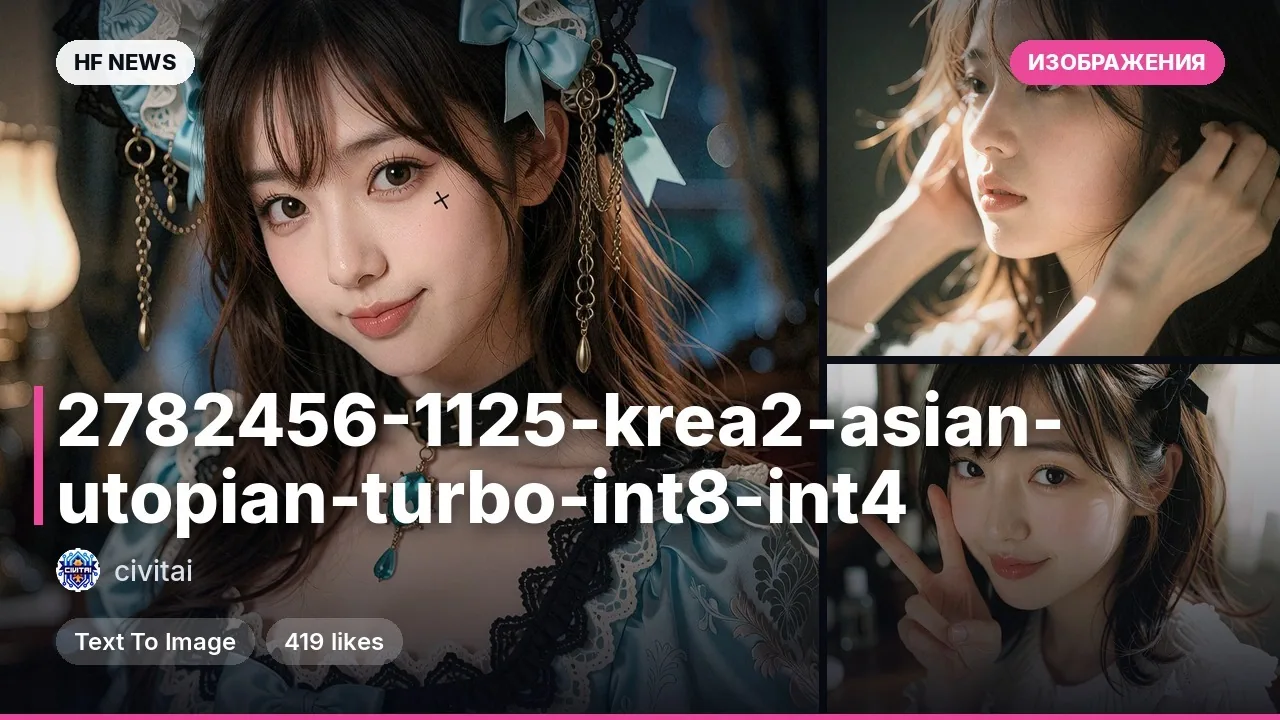
Автор hinablue представил портретный файнтюн на базе быстрой модели генерации изображений Krea 2 Turbo, заточенный под естественную передачу мимики, поз, текстуры кожи и фактуры тканей. В репозитории доступны сразу два формата: полные веса диффузионной модели v5.0-R4 (с уже вшитой портретной адаптацией) и отдельная AsianMix v6.0-R4 LoRA (небольшой файл-надстройка для оригинальной Krea 2 Turbo). В отличие от базовой модели, релиз сфокусирован на живых азиатских портретах с упором на реалистичные детали без эффекта сильного пластикового сглаживания. Подойдёт иллюстраторам и энтузиастам локальной генерации в ComfyUI, которым нужны быстрые портреты с естественным светом и текстурой.

Ключевые особенности

  • Два варианта установки: можно скачать готовые квантованные чекпоинты (INT8 ConvRot или компактный NVFP4) либо подключить лёгкую LoRA (223.84 МБ, rank 32) поверх базовой Krea 2 Turbo.
  • Высокая скорость генерации: модель наследует архитектуру Turbo и работает на 8 шагах (Steps) при CFG 1, без необходимости подключать дополнительные ускоряющие LoRA.
  • Проработанная текстура кожи: новая версия v6 LoRA обучена на датасете из 4 420 изображений с детальным описанием черт лица представителей четырёх стран (Япония, Корея, Тайвань, Таиланд).
  • Готовый граф для ComfyUI: в комплект входит файл Krea2Turbo with Lora.json с настроенными нодами выбора разрешения и постобработки плёночного зерна, свечения и резкости.

Что можно сделать

  • Генерировать студийные и уличные портреты: используйте триггер-фразу asian woman и шаблоны из caption_templates.txt для создания кадров с естественным дневным светом и мягкими тенями.
  • Сэкономить видеопамять без потери стиля: выберите сборку NVFP4 весом 7.98 ГБ вместо 13 ГБ у INT8 ConvRot, если ваша видеокарта и загрузчик ComfyUI поддерживают этот формат.
  • Гибко регулировать степень стилизации: поставьте отдельную LoRA на чистую Krea-2-Turbo, чтобы вручную крутить силу её влияния, или комбинируйте полные веса R4 с другими совместимыми LoRA.

Пример

Стартовый промпт из карточки для получения портрета у окна с естественной текстурой кожи (настройки для ComfyUI: 8 шагов, CFG 1, сэмплер euler / simple):
Asian woman, an adult Taiwanese woman with soft oval facial features, natural makeup and airy curtain bangs, wearing a cream linen blouse, seated beside a window in a quiet cafe, soft natural daylight, realistic skin texture with subtle imperfections, relaxed expression, portrait photography, gentle shadows and natural colors.

ПодробнееВес файлов: 13.00 GiB (INT8 ConvRot), 7.98 GiB (NVFP4) и 223.84 MiB (отдельная LoRA rank 32 / alpha 32); фактическое потребление VRAM выше из-за текстового энкодера qwen3vl_4b_fp8_scaled.safetensors и VAE qwen_image_vae.safetensors.
Обучение и сборка: LoRA v6 обучалась 2 эпохи (15 320 шагов) в Krea2 Trainer на 4 420 примерах, после чего была объединена с AsianMix v5.5-X и влита в чекпоинт v5.0-R4.
Ограничения: вес не совместим напрямую с Diffusers from_pretrained() и требует актуального ComfyUI; лицензия Krea 2 Community ограничивает коммерческое использование компаниями с годовой выручкой от $1 млн.


Примеры
Обсудить Telegram 1 103

Запустится ли?

Запустится в INT8

Влезает без сжатия.

  • INT8рекомендуемвеса 13 GB · готовые файлы16 GB
  • 4-bitвеса 7.3 GB9.5 GB

Совет: берите 8-bit.INT8 почти не отличается по качеству от полной точности (разница в пределах процента), а памяти занимает вдвое меньше и на RTX 40/50, H100 работает быстрее. Полную точность есть смысл брать только для дообучения.

Что взять под эту модель

Massed ComputeОткрыть Massed Compute

Своя видеокарта: INT8 — от RTX 5080

Почасовые цены Massed Compute на ноябрь 2026. Цена со скидкой — с промокодом при оплате.

Оценка: веса плюс рабочая память. Длинные ролики, высокое разрешение и большой контекст требуют больше.

Запуск на Massed Compute

Готовый скрипт под машину, которую мы советуем выше: вставили — модель скачалась и запустилась.

  1. 1. Арендуйте A30

    $0.26 в час с купоном. При создании машины выберите образ Ubuntu.

    Открыть Massed Compute
  2. 2. Вставьте скрипт в терминал машины

    Подключитесь по SSH (команда есть в панели Massed Compute) или откройте терминал на рабочем столе машины.

    HF_TOKEN / CIVITAI_TOKENВ начале скрипта строки для токенов: вставьте свой между кавычками. Токен Hugging Face нужен для закрытых моделей, токен Civitai — для моделей с Civitai.

    #!/usr/bin/env bash
    # 1125-Krea2Turbo-Asian-Utopian
    set -e
    # Драйвер NVIDIA: для CUDA 13 нужен 580+. Если старее или нет — ставится свежий nvidia-open (оставить свой: KEEP_DRIVER=1)
    DRV=$(nvidia-smi --query-gpu=driver_version --format=csv,noheader 2>/dev/null | head -1 | cut -d. -f1)
    case "$DRV" in ""|*[!0-9]*) DRV=0 ;; esac
    if [ "$DRV" -lt 580 ] && [ -z "${KEEP_DRIVER:-}" ]; then
      . /etc/os-release && \
      curl -fsSLO "https://developer.download.nvidia.com/compute/cuda/repos/ubuntu${VERSION_ID//./}/x86_64/cuda-keyring_1.1-1_all.deb" && \
      sudo dpkg -i cuda-keyring_1.1-1_all.deb && rm -f cuda-keyring_1.1-1_all.deb && \
      sudo apt-get update && \
      sudo DEBIAN_FRONTEND=noninteractive apt-get install -y nvidia-open || \
      { echo "Драйвер NVIDIA поставить не удалось: смотрите ошибку выше. Чтобы оставить текущий, запустите с KEEP_DRIVER=1."; exit 1; }
      echo "Драйвер NVIDIA обновлён. Перезагрузите машину (sudo reboot) и запустите этот же скрипт ещё раз."
      exit 0
    fi
    curl -LsSf https://astral.sh/uv/install.sh | sh
    source "$HOME/.local/bin/env"
    # CUDA 13+ → int8_convrot (так советует Comfy-Org), иначе fp8_scaled
    CU=$(nvidia-smi | grep -oP 'CUDA Version: \K[0-9]+' || echo 12)
    [ "$CU" -ge 13 ] && TORCH=cu130 || TORCH=cu128
    [ -d ~/ComfyUI ] || git clone https://github.com/comfyanonymous/ComfyUI ~/ComfyUI
    cd ~/ComfyUI
    uv venv --python 3.12 --allow-existing && source .venv/bin/activate
    uv pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/$TORCH
    uv pip install -r requirements.txt "huggingface_hub[cli]"
    # Базовые файлы: Krea 2, 8-bit
    if [ "$CU" -ge 13 ]; then
      hf download Comfy-Org/Krea-2 text_encoders/qwen3vl_4b_int8_convrot.safetensors vae/qwen_image_vae.safetensors --local-dir models
    else
      hf download Comfy-Org/Krea-2 text_encoders/qwen3vl_4b_fp8_scaled.safetensors vae/qwen_image_vae.safetensors --local-dir models
    fi
    # Основная модель: 1125-Krea2Turbo-Asian-Utopian
    hf download hinablue/1125-Krea2Turbo-Asian-Utopian 1125_hinaKrea2Turbo_AsianUtopian_v5.0-R4-int8-convrot.safetensors --local-dir models/diffusion_models
    # Запуск ComfyUI. Со своего компьютера: ssh -L 8188:localhost:8188 пользователь@IP, затем http://localhost:8188
    python main.py --listen 127.0.0.1 --port 8188
    Добавить ещё LoRA к 1125-Krea2Turbo-Asian-Utopian
  3. 3. Пользуйтесь

    Со своего компьютера: ssh -L 8188:localhost:8188 пользователь@IP-машины, затем откройте http://localhost:8188. Или откройте этот адрес в браузере на рабочем столе машины. Workflow для модели обычно лежит в её карточке на Hugging Face.

Не забудьте остановить машину в панели, когда закончите: оплата идёт поминутно, пока она включена.

Как ускорить

Подобрано под тип модели. Выберите своё железо в блоке выше — покажем то, что подходит именно вам.

  • SageAttention 3v2.2.0от 28 октября 2025

    ещё быстрее на RTX 50 / Blackwell

    FP4-внимание для Blackwell. Быстрее SageAttention 2, но авторы советуют 2-ю версию, когда важна точность.

    Как включить: Сборка из папки sageattention3_blackwell репозитория; в ComfyUI — через KJNodes.

    Предыдущие поколения (2)
    • SageAttention 2++ — Квантованное (INT8/FP8) внимание без заметной потери качества. Главное ускорение для генерации картинок и видео.
    • SageAttention 1 — Первая версия: INT8 для Q·K. Работает и на старых сборках, но 2++ быстрее и точнее.
  • FlashAttention 44.0.0b40от 18 ноября 2026новая версия

    самое быстрое точное внимание на B200

    Ядра для Blackwell (пока бета). Точное внимание без квантования — подходит для всего, включая LLM.

    Как включить: pip install flash-attn-4; vLLM и SGLang подхватывают сами.

    Предыдущие поколения (3)
    • FlashAttention 3 — Версия для Hopper (H100/H200) с FP8.
    • FlashAttention 2 — Стандарт для RTX 30/40/50 и A100: точное внимание без лишней памяти на длинных контекстах.
    • xFormers — Старый способ ускорить внимание, работает почти везде. Если есть Sage или Flash — они быстрее.
  • cache-dit (DBCache)v1.5.6от 20 ноября 2026новая версия

    1.5–3× при почти том же качестве

    Переиспользует результаты блоков между шагами диффузии. Поддерживает большинство DiT-моделей.

    Как включить: pip install cache-dit; одна строка cache_dit.enable_cache(pipe) для diffusers.

    Предыдущие поколения (2)
    • MagCache — Пропускает шаги по величине изменений. Точнее TeaCache без калибровки.
    • TeaCache — Первый массовый кэш шагов диффузии. Работает, но новые методы точнее.
  • Nunchaku (SVDQuant 4-bit)v1.2.1от 25 января 2026

    ≈3× быстрее и в 3.5× меньше памяти

    4-битные версии популярных моделей картинок почти без потери качества (FP4 на RTX 50).

    Как включить: Есть готовые веса для поддерживаемых моделей; в ComfyUI — ComfyUI-nunchaku.

  • torch.compile2.15.0от 28 октября 2026новая версия

    10–30% бесплатно

    Компилирует модель под вашу видеокарту. Первый запуск дольше, дальше быстрее.

    Как включить: model = torch.compile(model); в ComfyUI — узел TorchCompileModel.

Семья модели

Дообучение модели

krea/Krea-2-Turbo
  1. Krea-2-Rawоснова семьи
  2. Krea-2-Turbo
  3. 1125-Krea2Turbo-Asian-Utopian

Новые посты про версии Krea-2-Raw — сжатые, дообучения, LoRA — появятся в колокольчике.

Сжатые версии 12Все на Hugging Face
Дообучения 12Все на Hugging Face
LoRA и адаптеры 12Все на Hugging Face

О модели

hinablue/1125-Krea2Turbo-Asian-Utopian
Автор
hinablue
Категория
Изображения
Дата выхода
На сайте

На сайте

Hugging Face

1031

Спросить нейросеть об этой модели

Отвечает Gemini 4 · переписка хранится только в этой вкладке

Комментарии