гибридная языковая модель, обученная с нуля на Mac mini
schedule 3 мин чтенияобновлено
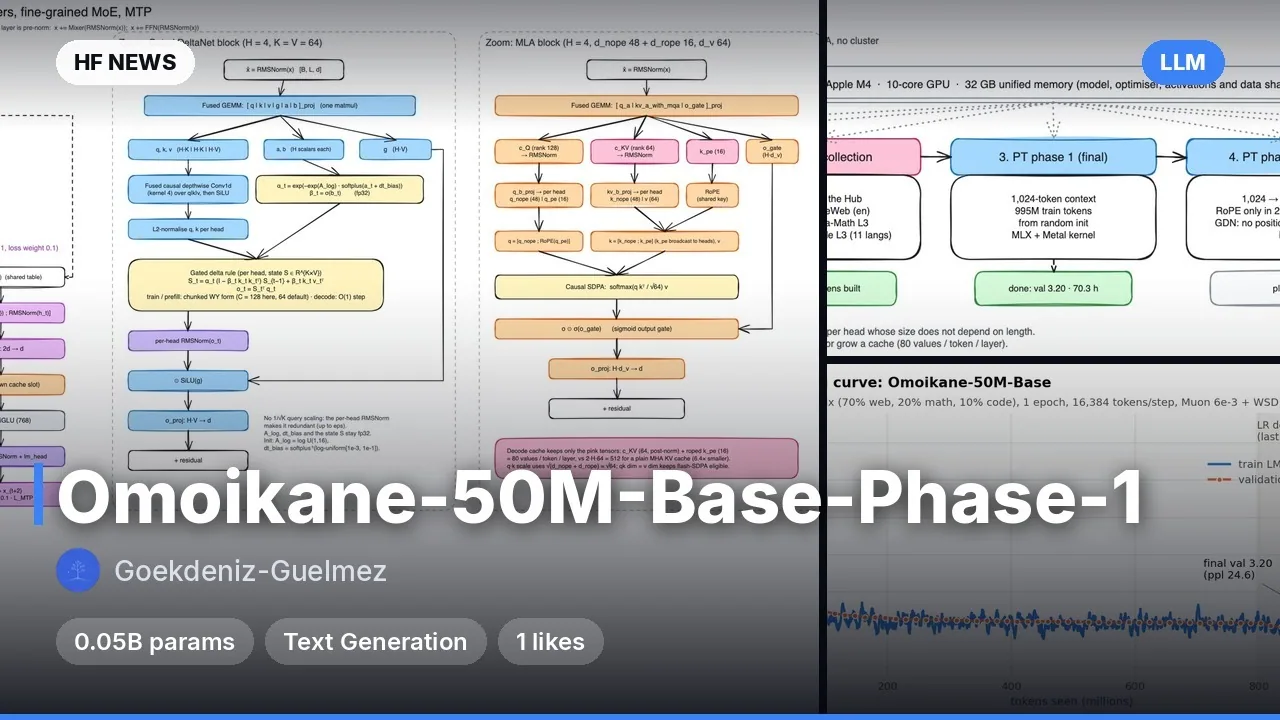
Omoikane-50M-PoC — исследовательская языковая модель (LLM) на 48,9 млн параметров от автора Gökdeniz Gülmez, созданная и обученная с нуля на одном Mac mini с чипом Apple M4 (32 ГБ объединенной памяти, без CUDA). Модель сочетает рекуррентные слои Gated DeltaNet (линейная по времени обработка последовательности с фиксированным состоянием), слои внимания MLA (Multi-head Latent Attention со сжатым KV-кэшем) и блоки MoE (Mixture-of-Experts — смесь экспертов, где на каждый токен активируется часть подсетей). Это proof-of-concept чекпоинт для проверки архитектуры перед полным обучением на 1 млрд токенов. Он умеет генерировать связный текст на английском языке, но не проходил настройку на инструкции и обладает ограниченными знаниями. Пригодится исследователям и энтузиастам MLX для изучения компактных гибридных архитектур на Apple Silicon.
Ключевые особенности
Гибридная архитектура: 8 слоев Gated DeltaNet для быстрого O(1) инференса и 2 слоя MLA (3-й и 7-й) для точного извлечения контекста.
Тонкозернистый MoE: в слоях 1–8 работают 16 экспертов (выбираются топ-4) плюс 1 общий эксперт с балансировкой нагрузки без вспомогательной функции потерь.
Multi-Token Prediction (MTP): дополнительная голова предсказывает токен t+2 (совпадает с жадным выбором основной головы в 60,5% случаев), что подходит для self-speculative decoding.
Обобщение по длине: модель обучалась на окнах по 1024 токена, но удерживает ровный loss на контексте до 4096 токенов без дообучения.
Оптимизация под MLX: обучение с кастомным Metal-ядром заняло 6,8 часа на Mac mini M4 при пиковом потреблении 13,1 ГБ памяти.
Что можно сделать
Запустить инференс на Apple Silicon: протестировать генерацию текста локально через нативный скрипт modeling_omoikane_mlx.py в фреймворке MLX или через transformers на PyTorch.
Изучить работу компонентов: воспроизвести эксперименты автора по отключению отдельных слоев и анализу специализации экспертов и горизонтов памяти голов GDN.
Дообучить под свои задачи: использовать чекпоинт как легкую базу для экспериментов с файнтюнингом (SFT) или расширением контекста на потребительском железе.
Пример
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

repo = "Goekdeniz-Guelmez/Omoikane-50M-PoC"
tok = AutoTokenizer.from_pretrained(repo, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(repo, trust_remote_code=True, dtype=torch.float32).eval()
inputs = tok("Photosynthesis is the process by which plants", return_tensors="pt")
out = model.generate(**inputs, max_new_tokens=64, do_sample=True, temperature=0.8, top_p=0.95, repetition_penalty=1.1)
print(tok.decode(out[0], skip_special_tokens=True))
ПодробнееБенчмарки (zero-shot): BLiMP — 72,9%, SciQ — 60,0%, PIQA — 54,6%, ARC-Easy — 39,2%, HellaSwag — 25,8%. Обучение: 1 эпоха на 103,7 млн токенов (fineweb-edu-100K), оптимизатор Muon (lr 6e-3, расписание WSD), итоговый validation loss — 4,0105 (perplexity 55,2). Железо: Mac mini M4 32 ГБ, пик памяти 13,1 ГБ, скорость обучения ~4000–4300 токенов/с. Ограничения: только английский язык, без инструктивного тюнинга, математику и код при обучении не видела, при жадном декодировании склонна к повторам.
Совет: берите 8-bit.FP8 / INT8 почти не отличается по качеству от полной точности (разница в пределах процента), а памяти занимает вдвое меньше и на RTX 40/50, H100 работает быстрее. Полную точность есть смысл брать только для дообучения.
Подключитесь по SSH (команда есть в панели Massed Compute) или откройте терминал на рабочем столе машины.
HF_TOKEN / CIVITAI_TOKENВ начале скрипта строки для токенов: вставьте свой между кавычками. Токен Hugging Face нужен для закрытых моделей, токен Civitai — для моделей с Civitai.
# Goekdeniz-Guelmez/Omoikane-50M-PoC — A30, FP8 / INT8
# Драйвер NVIDIA: для CUDA 13 нужен 580+. Если старее или нет — ставится свежий nvidia-open (оставить свой: KEEP_DRIVER=1)
DRV=$(nvidia-smi --query-gpu=driver_version --format=csv,noheader 2>/dev/null | head -1 | cut -d. -f1)
case "$DRV" in ""|*[!0-9]*) DRV=0 ;; esac
if [ "$DRV" -lt 580 ] && [ -z "${KEEP_DRIVER:-}" ]; then
  . /etc/os-release && \
  curl -fsSLO "https://developer.download.nvidia.com/compute/cuda/repos/ubuntu${VERSION_ID//./}/x86_64/cuda-keyring_1.1-1_all.deb" && \
  sudo dpkg -i cuda-keyring_1.1-1_all.deb && rm -f cuda-keyring_1.1-1_all.deb && \
  sudo apt-get update && \
  sudo DEBIAN_FRONTEND=noninteractive apt-get install -y nvidia-open || \
  { echo "Драйвер NVIDIA поставить не удалось: смотрите ошибку выше. Чтобы оставить текущий, запустите с KEEP_DRIVER=1."; exit 1; }
  echo "Драйвер NVIDIA обновлён. Перезагрузите машину (sudo reboot) и запустите этот же скрипт ещё раз."
  exit 0
fi
curl -LsSf https://astral.sh/uv/install.sh | sh
source "$HOME/.local/bin/env"
uv venv ~/vllm --python 3.12 && source ~/vllm/bin/activate
uv pip install vllm
vllm serve Goekdeniz-Guelmez/Omoikane-50M-PoC --max-model-len 8192 --quantization fp8
Сервер слушает порт 8000 и понимает запросы в формате OpenAI: адрес http://localhost:8000/v1 на машине. Со своего компьютера: ssh -L 8000:localhost:8000 пользователь@IP-машины.
Не забудьте остановить машину в панели, когда закончите: оплата идёт поминутно, пока она включена.
Как ускорить
Подобрано под тип модели. Выберите своё железо в блоке выше — покажем то, что подходит именно вам.


Комментарии