ВидеоFluid-Motion-AI
MiniMax H3
омнимодальное видео со стереозвуком
1 мин чтения
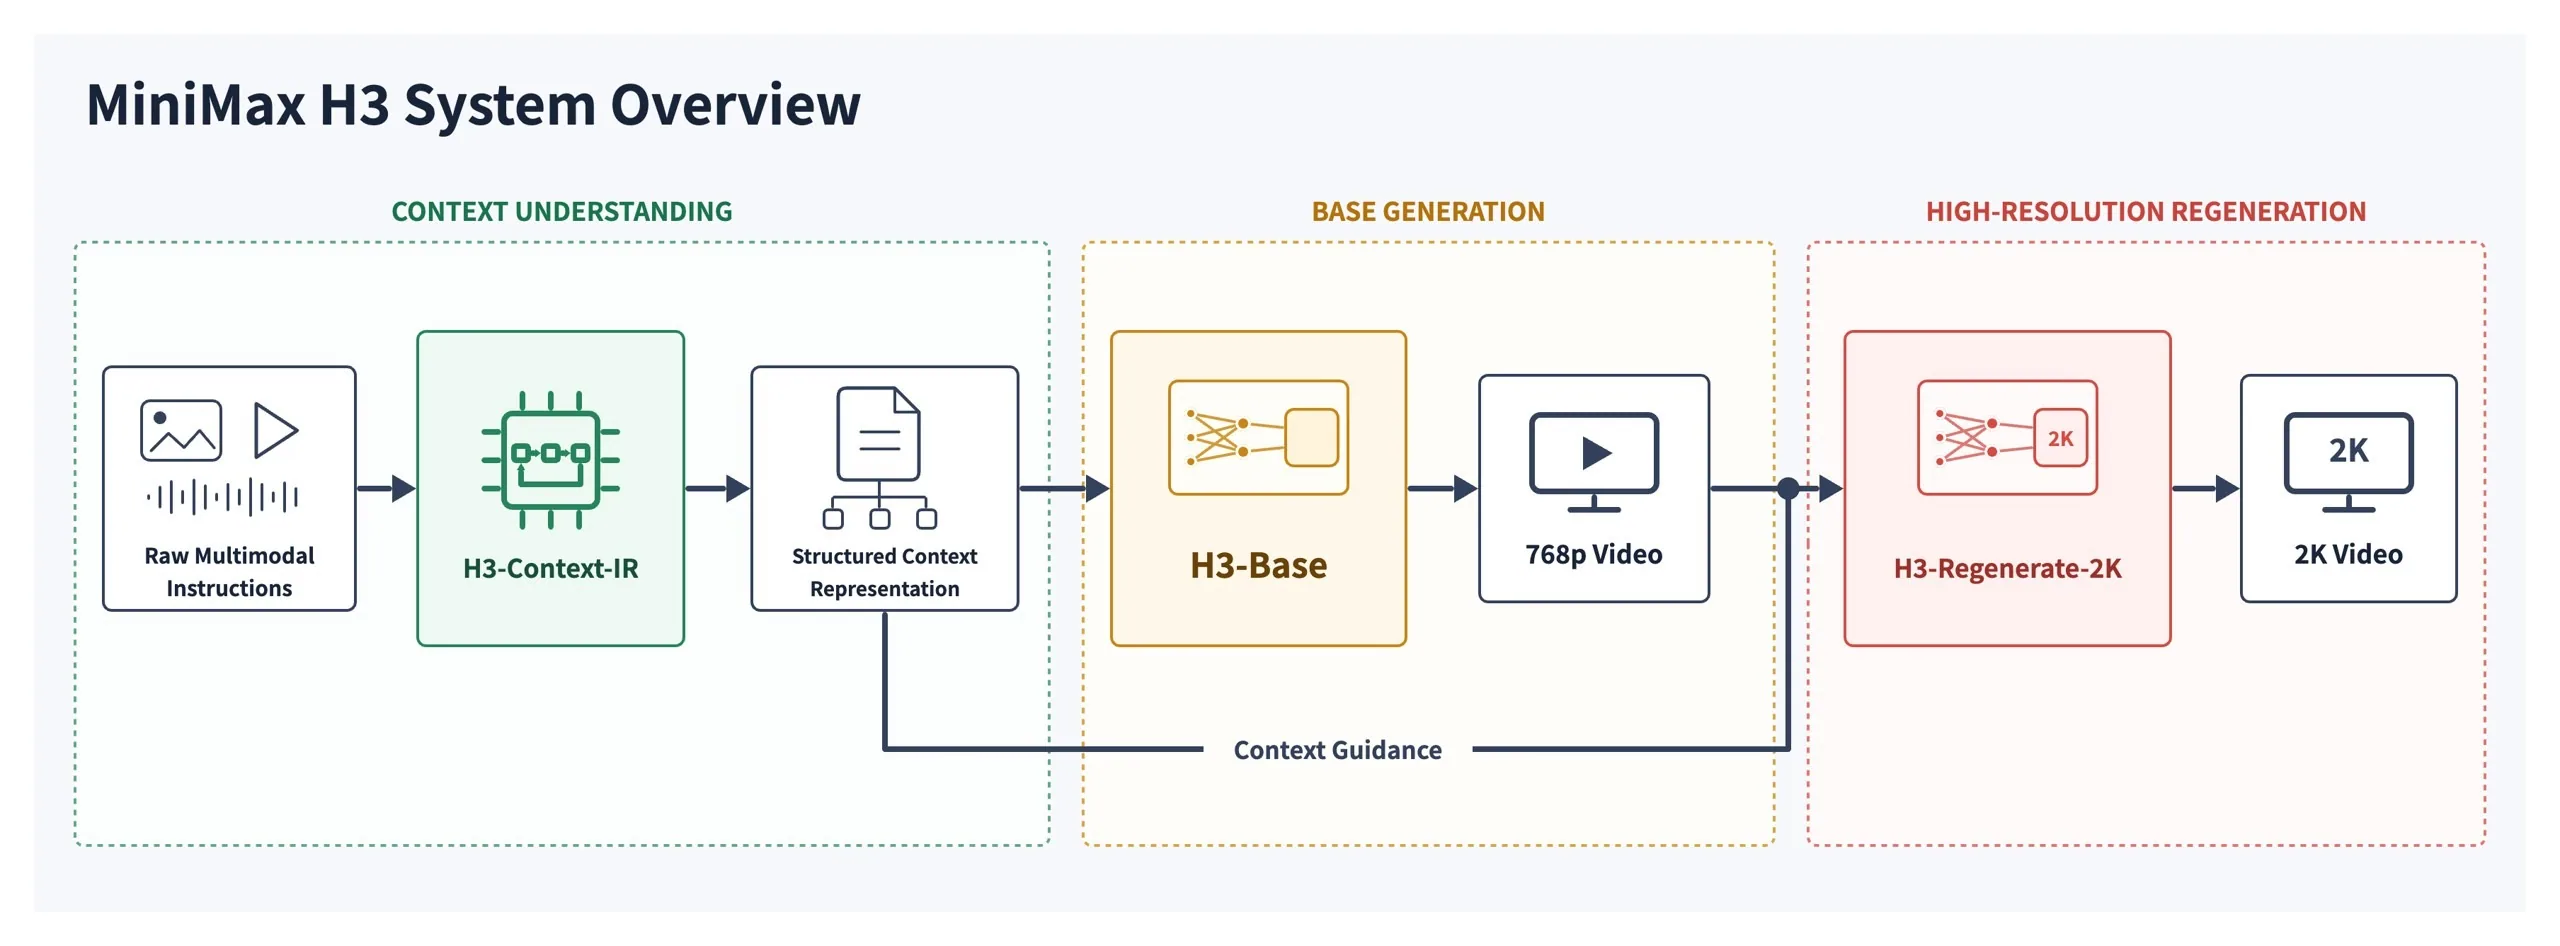
MiniMax H3 — general-purpose omni-modal generative system: понимает текст, изображения, видео и аудио и генерирует видео с нативным стереозвуком. В репозитории — веса H3-Base в двух чекпоинтах, FL2VA и Ref2VA; локально это 768p, 2K — через отдельный H3-Regenerate-2K.
🔍 Ключевые особенности
- 🔍 Омнимодальный вход: текст, изображения, видео и аудио; выход — видео со звуком.
- 🖥 H3-Base — 33B dense single-stream Omni-Transformer; энкодер — Qwen3-VL-32B, отдельные VisualVAE и AudioVAE.
- 🎙 Видео 4–15 секунд, 24 FPS, 32 kHz stereo, разные соотношения сторон; по умолчанию 768p.
- 📌 FL2VA: text-to-video или first/last-frame-to-video с 0–2 изображениями. Ref2VA: до 9 изображений, до 3 видео и 3 аудио, максимум 12 файлов.
- 🌐 Стабильная поддержка диалогов на 11 языках, включая русский.
- 💡 Чекпоинты CFG-distilled, BF16; есть diffusers-формат и загрузка для SGLang/vLLM.
💡 Пример
hf download MiniMaxAI/MiniMax-H3 --include "model_index.json" "FL2VA/*" "Ref2VA/*" --local-dir MiniMax-H3Подробнее
⚠ Открыты только веса H3-Base в BF16: H3-Context-IR и H3-Regenerate-2K пока не open-source, sparse attention в первом релизе нет.🖥 33B dense Omni-Transformer; ~13B параметров в AdaLN-ветках можно не загружать для inference-only.
📌 Локальный H3-Base даёт 768p; 2K — через H3-Regenerate-2K или API.
📊 Бенчмарков в карточке нет.
Комментарии
Без регистрации: достаточно имени.