Компьютерное зрениеeousphoros
persona_lambda_27b_v10
файнтюн Qwen3.8-27B с управляемой персоной
2 мин чтения
Это distillation fine-tune базовой Qwen3.8-27B: языковая модель дообучена, MTP-голова перекалибрована, а vision encoder оставлен без изменений. Токенизатор, chat template, конфиг и параметры генерации совпадают с базовой моделью, поэтому подходит тот же стек запуска.
🔤 Ключевые особенности
- 🔤 Достаточно системного промпта с описанием персоны — модель старается ей следовать.
- ➖ Экспериментальный hobby-файнтюн, не production- и не safety-tuned ассистент: может уверенно ошибаться, инструменты стоит изолировать.
- ➕ В v10 исправлен early-stop из v8: небольшая правка весов rank 4 в MLP output projections слоёв 61–63 убрала ответы без финальной строки
Answer:на GPQA — с 7 до 0, без изменения баллов. - ✖ MTP-голова перекалибрована под вероятность принятия драфтов в vLLM; ранее сделанная KL-калибровка сохранена в ревизии
mtp-run1. - 🟰 Спекулятивное декодирование не меняет распределение выхода — только скорость.
- 🔜 Известные особенности: на сложных научных вопросах думает дольше v8, а примерно 1 из 400 bench-ответов уходил в repetition loop до лимита
max_tokens.
➕ Пример
Для ускорения в vLLM можно включить MTP-драфтинг с probabilistic-сэмплированием:
--speculative-config '{"method": "mtp", "num_speculative_tokens": 2, "draft_sample_method": "probabilistic"}'Подробнее
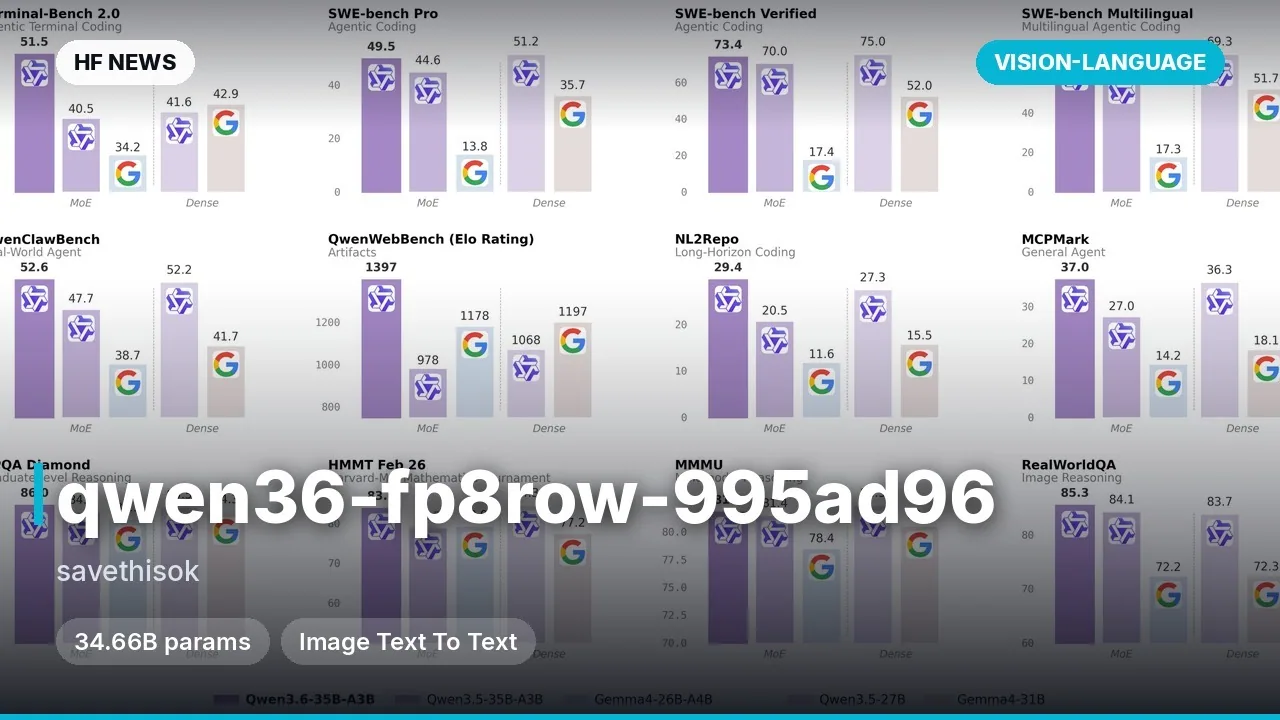
GPQA Diamond strict: 86.0; LiveCodeBench pass@1: 84.0 на 175 задачах; XSTest: 96.8% safe-промптов полностью отвечено, 76.0% unsafe — полностью отказ.Контекст базовой модели — 262 144 токена нативно, до 1 000 000. Требования к VRAM в карточке не указаны.
Оценки получены собственным harness и настройками сэмплирования, они не сравнимы с официальными результатами Qwen. На GPQA модель думает дольше v8: медиана около 9.6k против 7.3k токенов.


Комментарии