Qwen-Image-2.1-Lightning-v2-RL
четыре шага до картинки
1 min readupdated
Это RL-дообученная версия LightX2V Lightning v2, дистиллированная из Qwen-Image-2.1 (около 7,12 млрд параметров). Модель от lightx2v умеет text-to-image, редактирование по одному референсу и генерацию по нескольким референсам всего за 4 шага денойзинга при CFG = 1.0.
Ключевые особенности
- Всего 4 шага денойзинга и CFG = 1.0 — заметно быстрее базовых 40 шагов.
- Три режима: text-to-image, редактирование по одному изображению и генерация по нескольким референсам.
- Полные веса transformer в одном
diffusion_pytorch_model.safetensors; это не LoRA и не готовая pipeline-сборка. - Для инференса нужно загрузить processor, text encoder и VAE из Qwen-Image-2.1, затем подменить transformer.
- Веса хранятся в FP32, для инференса можно загружать в BF16.
- Не задавайте только
num_inference_steps=4— используйте сигмы изinference_config.json.
Пример
import json, torch
from diffusers import QwenImage21Pipeline, QwenImage21Transformer2DModel, FlowMatchEulerDiscreteScheduler
cfg = json.load(open("inference_config.json", encoding="utf-8"))
transformer = QwenImage21Transformer2DModel.from_pretrained(".", torch_dtype=torch.bfloat16)
pipe = QwenImage21Pipeline.from_pretrained(cfg["base_model"], transformer=transformer, torch_dtype=torch.bfloat16)
pipe.scheduler = FlowMatchEulerDiscreteScheduler(**cfg["scheduler"])
pipe.to("cuda")
Подробнее
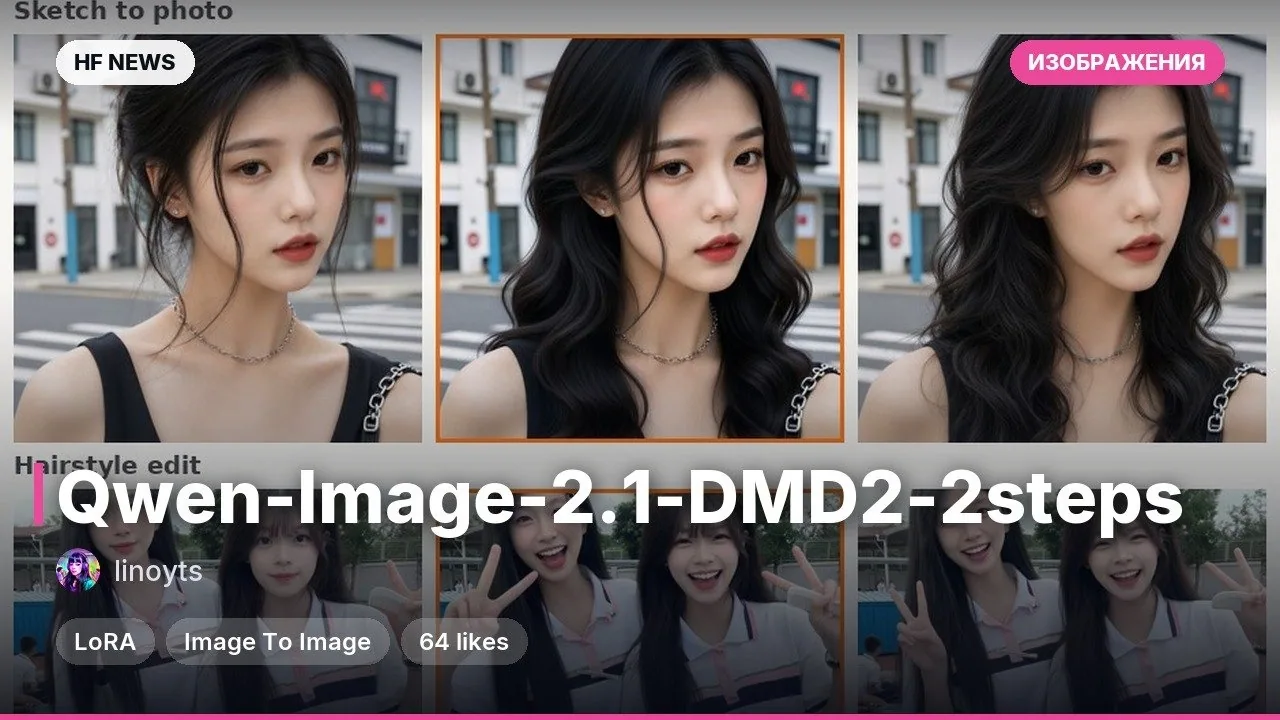
Сравнение в карточке: Lightning v2 RL — 4 шага, базовая Qwen-Image-2.1 — 40 шагов при CFG = 1.0 и 1024×1024.Требования к VRAM не указаны; веса FP32 можно загружать в BF16.
Качество зависит от промпта и seed: мелкий текст, анатомия, количество объектов и точность сохранения референсов могут требовать проверки.
Лицензия Qwen Research: некоммерческие условия.


Comments