HomeIMG-1.2B-PL-EN-epoch49
генератор картинок с нуля на 1024 px
2 min readupdated
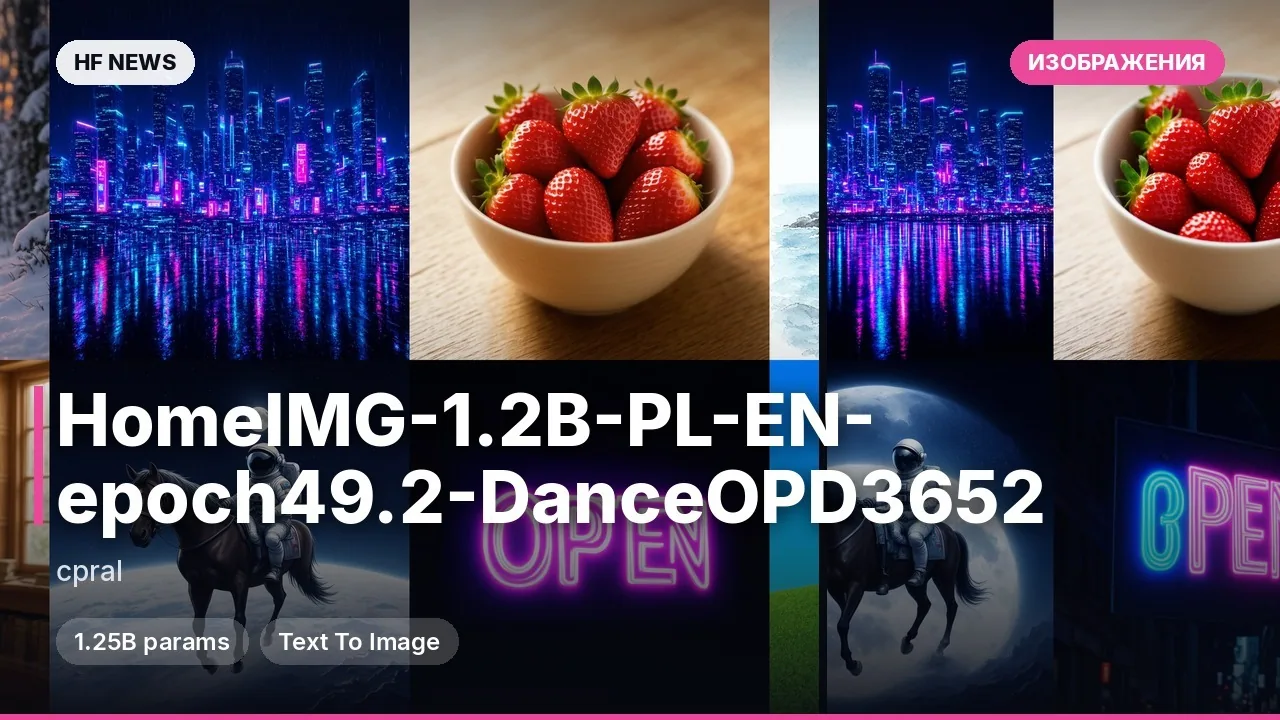
Двуязычная модель (польский и английский) для генерации изображений по текстовому описанию, обученная с нуля на 8 домашних видеокартах RTX 3090 Ti. В основе лежит архитектура DiT (Diffusion Transformer — диффузионный трансформер) на 1,24B параметров в связке с замороженным текстовым энкодером Poziomka-Baza, рефайнером на 72,1M параметров и декодером от FLUX.2. Главное отличие этой версии от прошлых эпох семейства HomeIMG — полноценная поддержка разрешения 1024×1024 px наряду с 512 и 256 px. Пригодится энтузиастам, которые ищут компактный генератор с открытым кодом обучения и возможностью запускать его на потребительском железе.
Ключевые особенности
- Мультиразрешение из коробки: модель обучалась одновременно на 256, 512 и 1024 px (в пропорции токенов 3:2:1), а пайплайн сам подбирает сдвиг расписания шума под выбранный размер картинки.
- Компактность и скорость: вес основного денойзера всего 1,24B параметров, текстовый энкодер сжат с экспертами в int8 — для генерации в 1024 px требуется около 12–16 ГБ VRAM.
- Двуязычные промпты: понимает запросы на польском и английском языках (обучалась на датасете FLUX-Reason-6M с 50% переведённых на польский подписей).
- Полностью открытый стек: в репозитории лежит код обучения, весовые коэффициенты распространяются под лицензиями Apache-2.0 и openmdw-1.1.
Что можно сделать
- Быстрое прототипирование сцен: генерировать черновики в 256 или 512 px, а затем переключать параметр
resolution=1024для получения детализированного результата тем же пайплайном. - Исследование диффузионных моделей: изучить на практике влияние сдвига расписания шума (t-shift) и смешанного обучения по разрешениям на композицию и отсутствие дублей объектов.
- Локальная генерация по-польски и по-английски: встроить модель через библиотеку
diffusersв локальный скрипт или бот на видеокарте с 12–16 ГБ видеопамяти.
Пример
import torch
from diffusers import DiffusionPipeline

REPO = "cpral/HomeIMG-1.2B-PL-EN-epoch49"
pipe = DiffusionPipeline.from_pretrained(REPO, custom_pipeline=REPO, trust_remote_code=True).to("cuda")
image = pipe("rudy kot śpiący na parapecie, fotografia", num_inference_steps=50, guidance_scale=3.0,
             generator=torch.Generator("cuda").manual_seed(0)).images[0]
image.save("kot.png")
Подробнее
Метрики val/loss (velocity MSE на 3584 отложенных картинках FLUX-Reason): 0,5079 (1024 px), 0,5589 (512 px) и 0,6210 (256 px).Требования: около 12–16 ГБ VRAM для 1024 px, версия diffusers с поддержкой AutoencoderKLFlux2.
Ограничения: в 1024 px всё ещё встречаются дубли объектов или голов (наследие первого этапа дообучения), текст на картинках нечитаемый, лица и кисти рук могут искажаться.
Обучение: 49 эпох суммарно на 8× RTX 3090 Ti с оптимизаторами MuLoCo, CMuon и AdamW.


Comments