Skip to content
Other

minipfn TabPFN-3.5

открытая репродукция табличного трансформера

2 min readupdated

Модель решает задачи классификации и регрессии на табличных данных с помощью in-context learning (обучения в контексте без дообучения весов на целевом датасете). Это написанная с нуля открытая репродукция архитектуры TabPFN-3.5 от автора aiden-jeon на 219M параметров (0.22B), обученная исключительно на синтетических данных из открытого генератора TabICL по трёхэтапной схеме TabICLv2. В отличие от многих табличных моделей, где под каждую задачу нужен отдельный чекпоинт, здесь один общий набор весов обслуживает сразу и классификацию, и регрессию. Пригодится ML-инженерам и исследователям, которым нужна полностью открытая альтернатива официальным весам Prior Labs для работы с таблицами.

Ключевые особенности

  • Единый мультизадачный чекпоинт: из 219M параметров 204.5M являются общими для обеих задач, а разделены только входные энкодеры меток и выходные головы.
  • Трёхступенчатая архитектура: последовательно обрабатывает ячейки (с преобразованием Фурье и ECDF-рангами), столбцы, строки и весь контекст через 24 слоя трансформера с QK-norm и QASSMax.
  • Работа с крупными таблицами: при обучении модель видела до 60 000 строк и 100 признаков, а на инференсе поддерживает до 1 000 000 обучающих строк, 6 000 признаков и 160 классов.
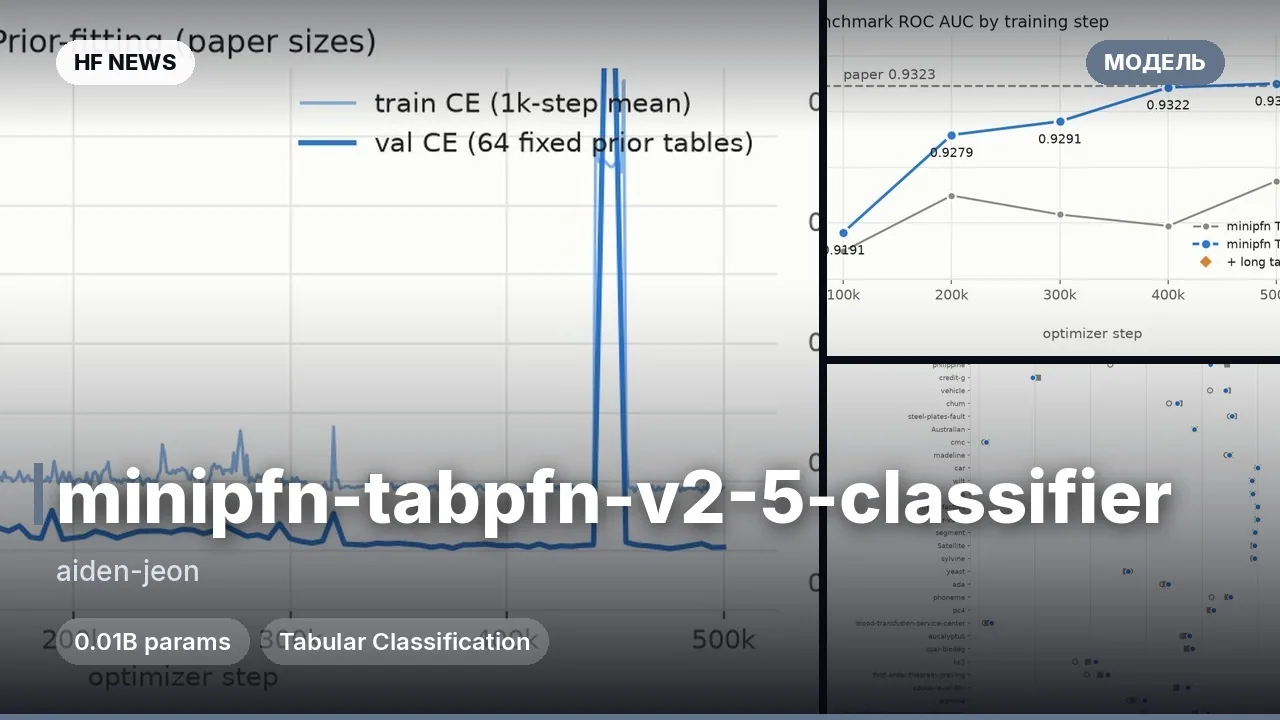
  • Стабилизация внимания: автор добавил soft-cap на логиты внимания (ограничение значением 50 через tanh), чтобы избежать схлопывания внимания при длительном обучении.

Что можно сделать

  • Решать задачи классификации: подать pandas DataFrame с числовыми и категориальными признаками в TabPFNv3_5Classifier и получить вероятности классов без градиентного бустинга.
  • Прогнозировать непрерывные значения: использовать TabPFNv3_5Regressor для регрессии на тех же весах, получая среднее по предсказанному распределению.
  • Экономить память при двух задачах: загрузить веса один раз через from_pretrained и передать общий объект модели одновременно в классификатор и регрессор.

Пример

from minipfn import TabPFNv3_5Classifier, TabPFNv3_5Regressor

clf = TabPFNv3_5Classifier(device="cuda").fit(x_train, y_train)
proba = clf.predict_proba(x_test)

reg = TabPFNv3_5Regressor(device="cuda").fit(x_train, y_train)
pred = reg.predict(x_test)
ПодробнееМетрики: на бенчмарке TabPFN v2 средний ROC AUC составил 0.9371 (выше 0.9323 из статьи TabPFN v2), геометрическое среднее отношения RMSE — 1.005.
Арены: 1556 Elo на TabArena-Lite (16-е место из 99, превосходит дефолтный XGBoost на 90% сплитов) и 1139 Elo на BeyondArena (против 1375 у официального TabPFN-3.5).
Железо и скорость: обучение заняло около 2 800 H100-часов (32×H100); на GPU используется ядро FlexAttention (в 1.3–2.2 раза медленнее обычного SDPA на 10k–30k строках, первый вызов компилируется ~20 сек).
Ограничения: модель видела только синтетику и слабее выступает на очень больших таблицах, временных разбиениях и категориях с высокой кардинальностью.

Примеры
Discuss Telegram 0 323

Will it run?

Runs in F32

Fits without quantisation.

  • F32weights 0.8 GB · ready files1.4 GB
  • BF16weights 0.4 GB0.9 GB
  • FP8 / INT8recommendedweights 0.2 GB0.7 GB
  • 4-bitweights 0.1 GB0.6 GB

Tip: go 8-bit.FP8 / INT8 is within about a percent of full precision in quality, takes half the memory and runs faster on RTX 40/50 and H100. Full precision only pays off for fine-tuning.

What to get for this model

Massed ComputeOpen Massed Compute

Your own GPU: FP8 / INT8 — from RTX 2060 · F32 — from RTX 2060

Massed Compute hourly prices, November 2026. The discounted price applies with the coupon at checkout.

Estimate: weights plus working memory. Long videos, high resolutions and long contexts need more.

Run it on Massed Compute

The script downloads the model to the rented machine. How to run it is in the model card.

  1. 1. Rent a machine with a fitting GPU

    Open Massed Compute
  2. 2. Paste the script into the machine's terminal

    Connect over SSH (the Massed Compute panel shows the command) or open a terminal on the machine's desktop.

    HF_TOKEN / CIVITAI_TOKENThe script starts with token lines: paste yours between the quotes. The Hugging Face token is for gated models, the Civitai one for Civitai models.

    # aiden-jeon/minipfn-tabpfn-v3-5
    mkdir -p ~/models
    curl -LsSf https://astral.sh/uv/install.sh | sh
    source "$HOME/.local/bin/env"
    uv tool install "huggingface_hub[cli]"
    hf download aiden-jeon/minipfn-tabpfn-v3-5 --local-dir ~/models/minipfn-tabpfn-v3-5
    # The model is in ~/models. How to run it is in the model card (link above).
    Add more LoRAs to minipfn-tabpfn-v3-5
  3. 3. Use it

    The model is in ~/models. How to run it is in the model card (link above).

Stop the machine in the panel when you are done: it bills by the minute while it runs.

How to speed it up

Picked for this model type. Choose your hardware above to see what fits you exactly.

  • FlashAttention 44.0.0b40from November 18, 2026new release

    fastest exact attention on B200

    Kernels for Blackwell (beta). Exact attention without quantisation — fine for everything, LLMs included.

    How to enable: pip install flash-attn-4; vLLM and SGLang pick it up themselves.

    Earlier generations (2)
    • FlashAttention 3 — The Hopper (H100/H200) version with FP8.
    • FlashAttention 2 — The standard for RTX 30/40/50 and A100: exact attention without the memory cost of long contexts.
  • torch.compile2.15.0from October 28, 2026new release

    10–30% for free

    Compiles the model for your GPU. Slower first run, faster afterwards.

    How to enable: model = torch.compile(model); in ComfyUI the TorchCompileModel node.

Model family

New posts about versions of minipfn-tabpfn-v3-5 (quants, finetunes, LoRAs) will show up under the bell.

No known relatives of this model yet. All derivatives on Hugging Face

About the model

aiden-jeon/minipfn-tabpfn-v3-5
Author
aiden-jeon
Category
Other
Released
Posted

On NeyroLearn

Hugging Face

3230

Ask AI about this model

Answered by Gemini 4 · the chat is kept only in this tab

Comments

Other

LayaLink

LayaLink