Авторская тема
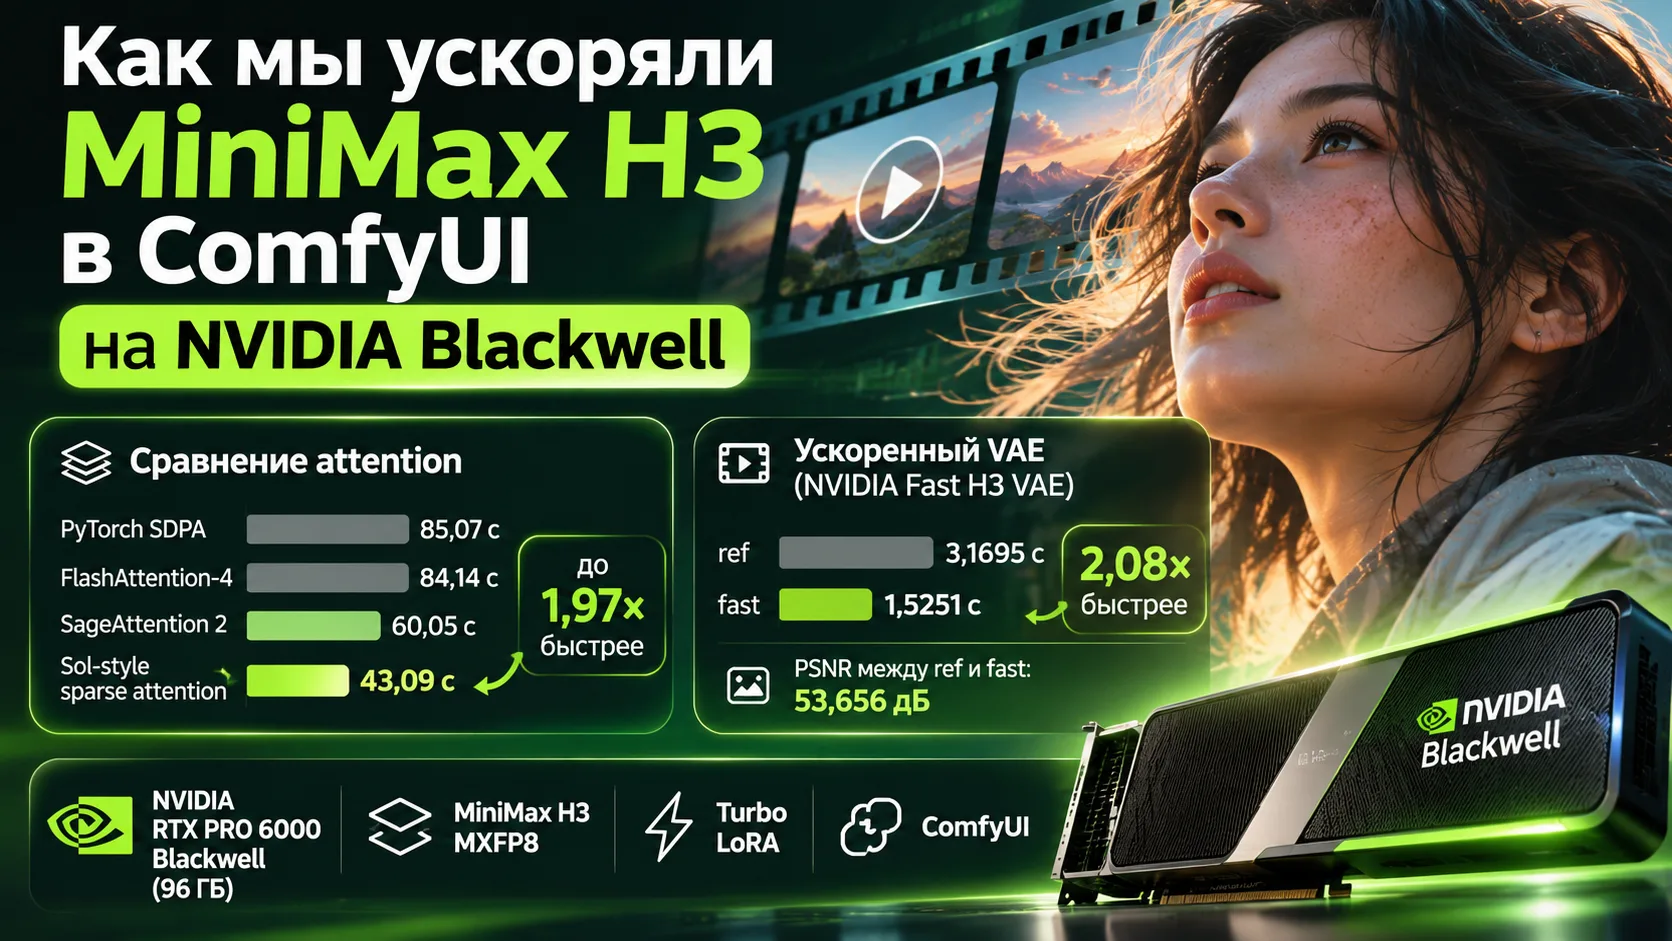
Как мы ускоряли MiniMax H3 в ComfyUI на NVIDIA Blackwell
FlashAttention-4 84,14 с 1,01× Базовый PyTorch SDPA 85,07 с 1,00× мы ожидали большего.
 prisstik Основатель@prissetik
Мы решили проверить, насколько можно ускорить генерацию видео с MiniMax H3, используя оптимизации NVIDIA и разные реализации attention непосредственно в ComfyUI.
Для тестов мы взяли NVIDIA RTX PRO 6000 Blackwell с 96 ГБ видеопамяти. Нам было интересно не просто запустить модель, а понять, какие оптимизации действительно помогают в конкретном workflow и какой эффект они дают по отдельности.
За основу взяли модель MiniMax H3 в формате MXFP8, применили Turbo LoRA и сравнили несколько вариантов attention. После этого отдельно проверили ускоренный декодер видео NVIDIA Fast H3 VAE.
Сравнение attention: от 85 до 43 секунд
Для первого теста мы использовали одинаковые настройки: разрешение 1344 × 768, 124 кадра, 10 шагов генерации и одинаковый seed. Модель была загружена заранее, а для каждого варианта мы провели по три измерения. В таблице указана медиана.
Здесь измерялось время генерации латента: декодирование VAE, upscale и сохранение видео в эти цифры не входят.
| Attention | Медианное время | Ускорение относительно базового варианта |
|---|---|---|
| Базовый PyTorch SDPA | 85,07 с | 1,00× |
| FlashAttention-4 | 84,14 с | 1,01× |
| SageAttention 2 | 60,05 с | 1,42× |
| Sol-style sparse attention | 43,09 с | 1,97× |
Самым заметным результатом в этом тесте оказался sparse attention: время генерации латента сократилось почти вдвое относительно базового варианта.
Важно уточнить, что мы проверяли Sol-style sparse attention через реализацию BlockSparseAttention, встроенную в ComfyUI. Отдельный проект ComfyUI-SolAttn_triton от Kijai мы изучали, но цифра 43,09 секунды относится именно к протестированному варианту BlockSparseAttention.
- ComfyUI-SolAttn_triton от Kijai — https://github.com/kijai/ComfyUI-SolAttn_triton
Результат FlashAttention-4 сначала показался подозрительным: разница с базовым вариантом составила меньше секунды. При проверке выяснилось, что в базовой конфигурации PyTorch уже использовал эффективный flash attention. То есть мы сравнивали две оптимизированные реализации, а не FlashAttention-4 с медленным необработанным attention.
Это не означает, что FlashAttention-4 бесполезен. Это означает, что в нашем конкретном тесте замена уже работавшего flash attention дала небольшой прирост. При других формах данных, моделях и конфигурациях результат может отличаться.
Для MXFP8 мы также проверили фактическое выполнение: модель загружалась в этом формате, а вычисления использовали scaled_mm_mxfp8. В отдельной проверке штатный путь занял около 85,09 с, а принудительная эмуляция — 101,36 с. Это были одиночные измерения после прогрева, поэтому их стоит воспринимать как предварительную проверку, а не полноценное статистическое сравнение.
Ускоренный VAE: 3,17 против 1,53 секунды
Следующим шагом мы отдельно проверили Fast H3 VAE от NVIDIA. VAE превращает сгенерированный латент в готовые кадры, поэтому его скорость тоже влияет на общее время получения видео.
Для теста мы создали отдельные ноды ComfyUI и сравнили два режима одного и того же Fast H3 VAE на одном латенте:
- ref — эталонная реализация Fast VAE на PyTorch.
- fast — ускоренная реализация NVIDIA с FlashAttention-4, quack, Triton и CUDA Graph.
Оба режима использовали одни и те же веса. Мы сделали прогрев, после чего провели по три замера на латенте размером 1344 × 768 и 124 кадра.
| Режим | Замеры | Медиана |
|---|---|---|
| Fast VAE ref | 3,1682 / 3,1695 / 3,1706 с | 3,1695 с |
| Fast VAE fast | 1,5242 / 1,5251 / 1,5256 с | 1,5251 с |
Ускоренный режим декодировал тот же латент примерно в 2,08 раза быстрее. Время включает декодирование и преобразование кадров, но не включает начальную загрузку весов, прогрев, генерацию латента и сохранение видео.
Мы также сравнили полученные кадры: PSNR между ref и fast составил 53,656 дБ. Это показывает, насколько близки результаты двух реализаций одного Fast VAE на нашем тестовом латенте.
Здесь есть важное ограничение: мы не сравнивали Fast VAE с полным оригинальным VAE MiniMax. NVIDIA указывает, что сам Fast H3 VAE является приближением относительно выпущенного полного декодера; приведённые нами 53,656 дБ относятся только к сравнению двух режимов Fast VAE.
- Описание Fast H3 VAE от NVIDIA — https://github.com/NVlabs/Sana/blob/sol-engine/models/Open-H3-Regenerate-2K/README.md
Что мы получили
В нашей конфигурации наиболее существенное ускорение генерации дал sparse attention: 85,07 → 43,09 секунды для латента. Отдельно ускоренный движок Fast H3 VAE сократил время декодирования с 3,17 до 1,53 секунды.
Эти цифры нельзя напрямую выдавать за полное время готового видео или переносить на любую модель и видеокарту. Это замеры отдельных частей конкретного workflow на RTX PRO 6000 Blackwell. Кроме того, мы пока не проводили полноценную оценку визуального качества sparse attention на широком наборе сцен — скорость нужно рассматривать вместе с такой проверкой.
Для нас главный вывод — оптимизации стоит измерять по отдельности. Название технологии само по себе не гарантирует одинакового ускорения: результат зависит от того, что уже делает базовый движок, какие размеры данных обрабатываются и какая часть pipeline ограничивает скорость.
Ссылки на проекты
- NVIDIA Sol Video Inference Engine — https://nvlabs.github.io/Sana/Sol-Engine/
- NVIDIA Open-H3-Regenerate-2K и описание Fast H3 VAE — https://github.com/NVlabs/Sana/blob/sol-engine/models/Open-H3-Regenerate-2K/README.md
- Веса NVIDIA Open-H3-Regenerate-2K на Hugging Face — https://huggingface.co/Efficient-Large-Model/Open-H3-Regenerate-2K
- ComfyUI-Open-H3-Regenerate — https://github.com/rdh9616/ComfyUI-Open-H3-Regenerate
- ComfyUI-SolAttn_triton от Kijai — https://github.com/kijai/ComfyUI-SolAttn_triton
- FlashAttention — https://github.com/Dao-AILab/flash-attention
- SageAttention — https://github.com/thu-ml/SageAttention
- #minimaxh3
Комментарии