Авторская тема
MoE: точность выросла с 59,7% до 71,3% благодаря повторному выбору экспертов
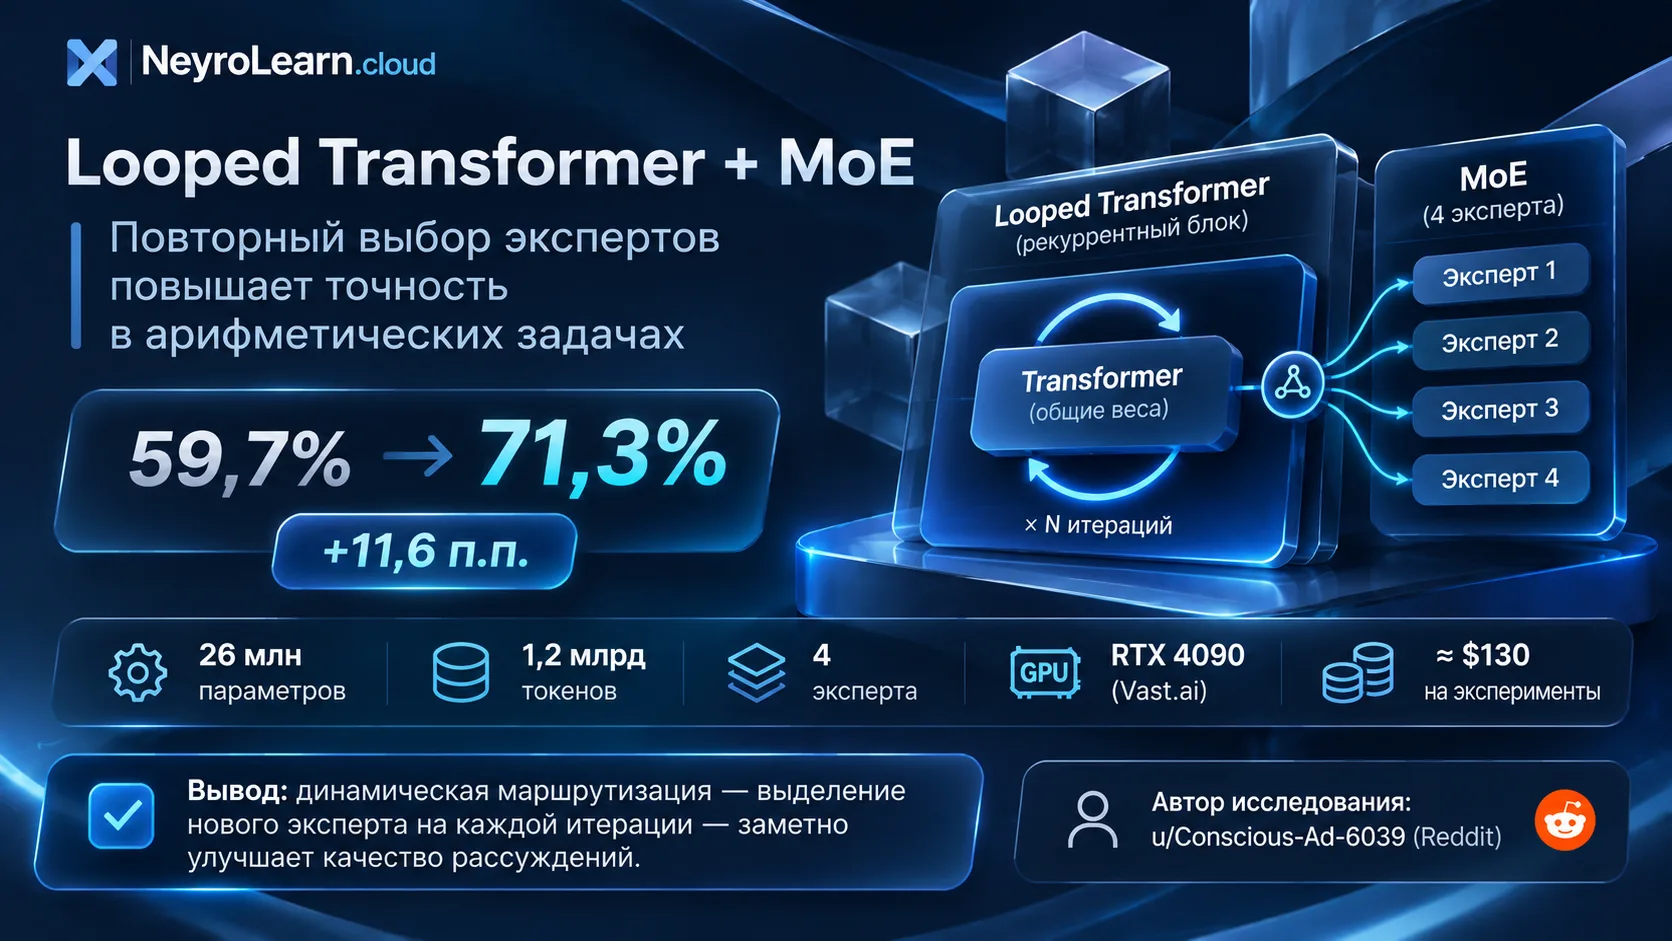
Looped Transformer + MoE: точность выросла с 59,7% до 71,3% благодаря повторному выбору экспертов
prisstik Основатель@prissetik
Looped Transformer + MoE: точность выросла с 59,7% до 71,3% благодаря повторному выбору экспертов
Независимый разработчик воспроизвёл архитектуру NVIDIA Dory на модели всего с 26 млн параметров и обнаружил интересную особенность: повторный выбор MoE-экспертов на каждой итерации заметно улучшает решение многошаговых математических задач.
В обычном Transformer каждый слой имеет собственные веса. В Looped Transformer один и тот же блок используется несколько раз, позволяя модели последовательно уточнять внутренние представления без увеличения количества параметров.
Автор эксперимента добавил четыре небольших MoE-эксперта в общий рекуррентный блок и сравнил два подхода:
- Фиксированная маршрутизация: эксперт выбирается на первой итерации и используется на всех последующих.
- Динамическая маршрутизация: модель заново выбирает эксперта для каждого токена перед каждой итерацией.
Результаты
| Подход / Метрика | Значение |
|---|---|
| Фиксированный выбор экспертов | 59,7% точности |
| Повторный выбор экспертов | 71,3% точности |
| Прирост | 11,6 процентного пункта |
| Test loss в обоих случаях | 1,711 |
Улучшение наблюдалось во всех трёх запусках с разными seed. Наибольшая разница проявилась в сложных арифметических задачах с несколькими последовательными операциями.
Параметры эксперимента
- 26 млн параметров.
- 1,2 млрд обучающих токенов на модель.
- 4 MoE-эксперта.
- PyTorch и арендованные RTX 4090 через Vast.ai.
- Около $130 на описанную серию экспериментов.
Ещё один интересный результат — «one-loop tax»
Автор также воспроизвёл эффект, при котором модель, обученная только с одной итерацией, практически сравнялась с рекуррентной моделью на трёх итерациях, потребляя примерно втрое меньше вычислений при инференсе.
Это показывает, что дополнительные циклы не всегда дают реальный выигрыш: часть улучшения может быть лишь компенсацией особенностей обучения с переменным числом итераций.
Почему это важно?
Эксперимент предполагает, что последовательное применение разных экспертов может быть полезнее фиксированного выбора на всех этапах вычислений. Это потенциально интересное направление для компактных reasoning-моделей, где важно эффективно использовать ограниченное количество параметров.
Однако результаты пока получены на маленьких моделях и ограниченном наборе задач. Для подтверждения эффективности подхода на крупных LLM потребуются дополнительные исследования.
Автор исследования: [u/Conscious-Ad-6039 (Reddit)](https://www.reddit.com/r/learnmachinelearning/comments/1xv9asm/reselecting
Исходный код, тесты и журнал экспериментов: https://github.com/Davidooff/Spidory
Основа архитектуры: NVIDIA Dory.
#LLM #MoE #Transformer #NVIDIA #PyTorch #Reasoning #Исследования
Комментарии